在前几节的内容中介绍了LVDS的相关知识,并在Quartus下生成相关的IP核,本节内容着重介绍与数据发送相关的最基本的几个部分内容。随后在收发交互中不断提出问题并解决问题,做到整个内容不断推进。并将整个高速通信分为五个阶段(工程):
- 第一阶段:基本通信框架
- 第二阶段:信道编码
- 第三阶段:异步过程与数据缓冲
- 第四阶段:CPU/DSP接口
- 第五阶段:多机通信网络的构建与数据容错
1.准备工作
上节内容中将LVDS的RX,TX 的核已经生成并例化,本节以100M的串行数据为例逐渐实现高速通信的框架工程。在上节课建立的工程基础上继续完善第一个阶段的设计。
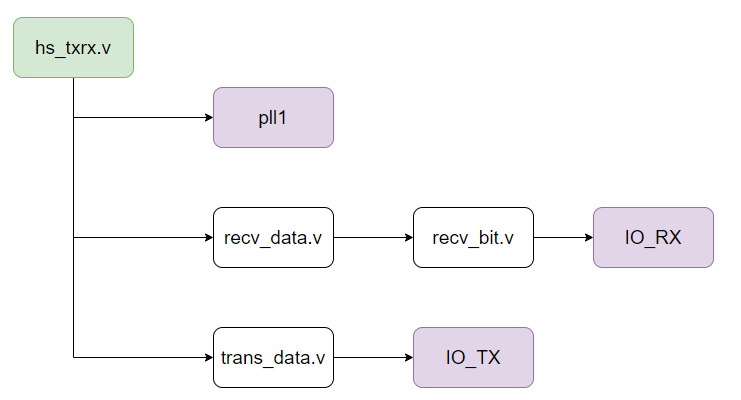
图1
-
新建文件hs_txrx.v并建立通信基本框架,并作为整个工程的顶层文件。
module hs_txrx
(
    input inclk,
    input pll_rst,
    input [9:0] tx_data,
    output tx,
    input rx,

    output rx_data_vld,
    output [9:0] rx_data,

    output clk_10M,
    output pll_locked
);

wire clk_100M;
wire clk_400M;
wire rst = !pll_locked;

trans_data trans_data_inst
(
    .rst      (rst),
    .clk_10M  (clk_10M),
    .clk_100M (clk_100M),
    .tx_data  (tx_data), // 10M的时钟对应的数据
    .tx_out   (tx)
);

recv_data recv_data_inst
(
    .rst         (rst),
    .clk_100M    (clk_100M),
    .clk_400M    (clk_400M),
    .rx          (rx),
    .rx_data     (rx_data),
    .rx_data_vld (rx_data_vld)
);

pll1 pll1_inst
(
    .areset ( pll_rst ),  //1'b0;
    .inclk0 ( inclk ),    //50Mhz
    .c0     ( clk_10M),   //10Mhz
    .c1     ( clk_100M ), //100Mhz
    .c2     ( clk_400M ), //400Mhz
    .locked ( pll_locked )
);

endmodule
在hs_txrx.v文件中包含三个module的例化,trans_data.v, recv_data.v分别是数据的发送与接收模块。
- trans_data模块:发送的数据来自接口tx_data,该数据与10M时钟同步,串行化后的数据流tx送往端口。
- recv_data模块:将接收到的10 bits数据rx_data送往端口并输出,同时伴随数据的,还有数据起始指示标志rx_data_vld。串行输入数据流rx也来自端口。本程序将一次性实现全双工的串行数据通信。
由于收发系统需要10M,100M,400M 时钟进行测试,因此生成PLL模块pll1并例化,PLL的输入时钟频率设定为50M,后续实验可以在FII-PRA006开发板上进行演示。
PLL 的复位脚由接口引入“.areset ( pll_rst ), ”,目的是在利用modelsim仿真时可以使PLL可靠工作。如果PLL仅作为综合部件也可以直接输入1’b0,如“.areset ( 1’b0 ), ”。PLL的生成过程前面的课程已有详细介绍,这里不再累述。
-
建立recv_data框架
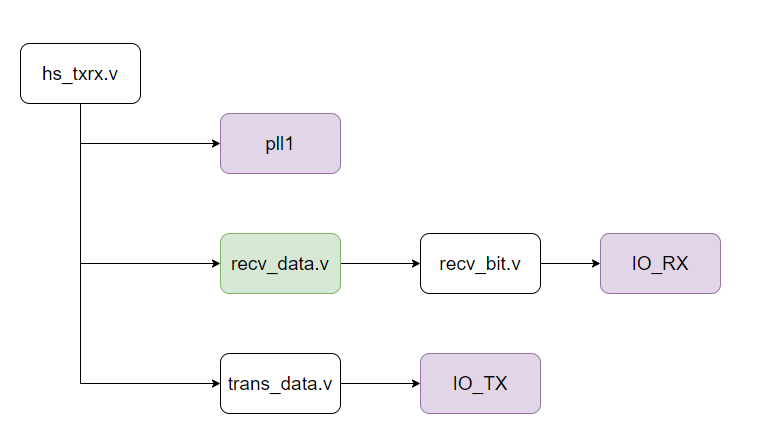
图2
recv_data模块功能这里没有完全实现,仅实现了基本框架和LVDS RX的例化,保持在系统编译时不会出错,recv_data程序如下:
module recv_data
(
    input                    rst,
    input                    clk_100M,
    input                    clk_400M,
    input                    rx,

    output reg[9:0]          rx_data,
    output reg               rx_data_vld,
    output                   rx_out
);

always@(posedge clk_100M or posedge rst)
if(rst) begin
    rx_data <= 0;
    rx_data_vld <= 0;
end
else begin
    rx_data <= 0;
    rx_data_vld <= 0;
end

IO_RX IO_RX_inst
(
    .rx_in  ( rx ),
    .rx_out ( rx_out )
);

endmodule
2.数据发送机串行化模块
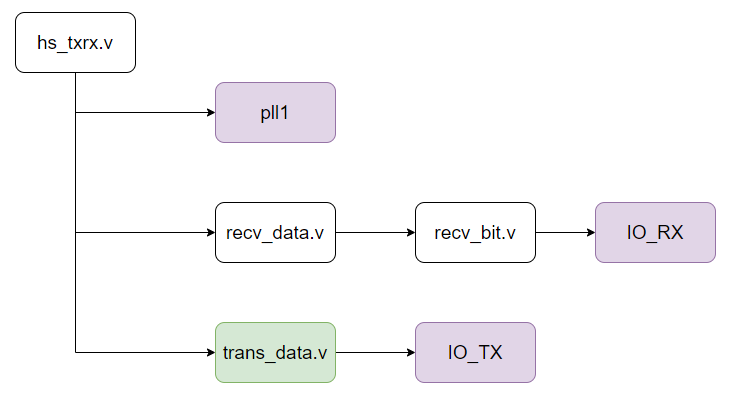
图3
发送端的数据与10M时钟同步,数据宽度为10 bits;采用10 bits的数据宽度,主要目的是为了保持将来在信道编码时保持底层串行化一致(由于采用了8b/10b)编码。由于需要串行化,因此需要比10 MHz频率快十倍的时钟进行串行化。由于10M/100M时钟有存在异步时钟域的可能性,将位宽为10 bits 成功的交换到100M时钟域一般要进行特殊处理。一般有两种办法进行处理:
(1)两个时钟看作同步时钟,仅用一次数据锁存便可以成功过渡到100M时钟域。如:
always@(posedge clk_100M)
data_100M <= data_10M;
但这种平滑交换需要满足如下条件:
-
- 这两个时钟需要同源
- PLL在设定时应为源同步补偿模式,如图4
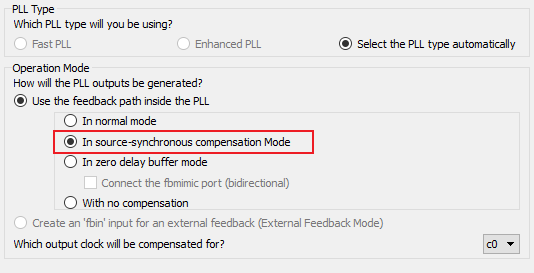
图4
-
- 两个时钟之间存在整数倍关系
- 10M保持0相位偏移,100M偏移180°,如图5。其实只要保证捕获时钟比原始数据时钟相对偏移180°即可,不一定要求10M时钟偏移为0。当然也可以选择90°或270°可跟据实际情况确定。这里选择偏移180°。正确设定后,仿真的波形图如图6所示。
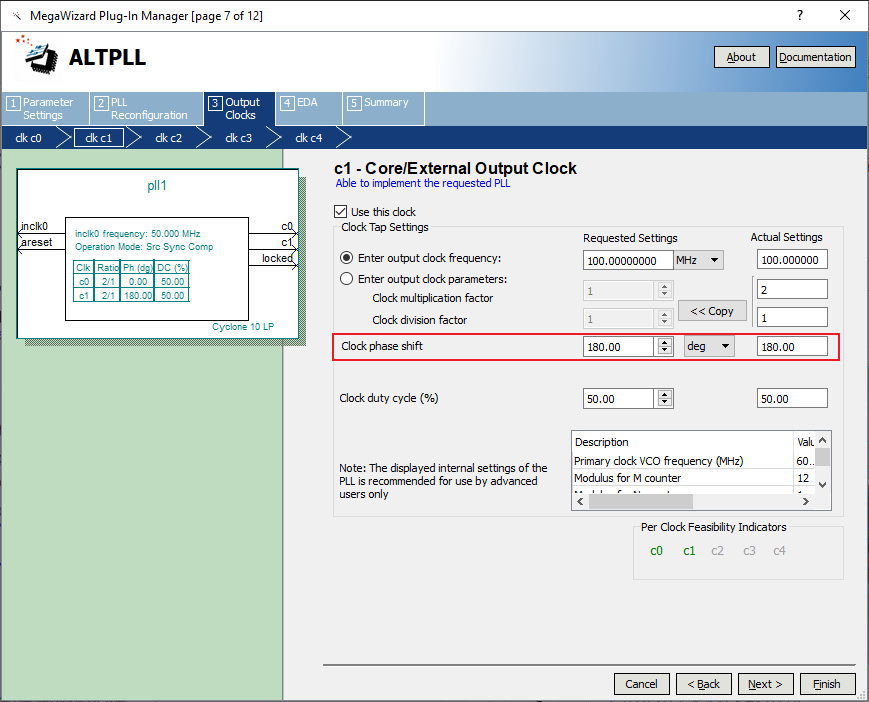
图5
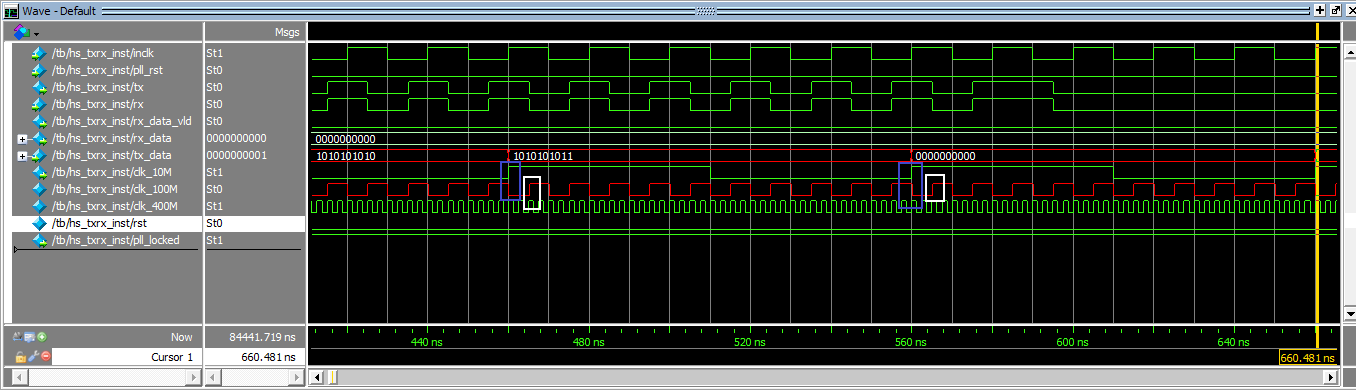
图6
从图6的波形图可以看出,tx_data数据在时钟clk_10M 上升沿时进行数据变化,而clk_100M的上升沿总是滞后半个100M的时钟,最终只要满足100M时钟的时序收敛,clk_100M时钟抓取与clk_10M同步的数据总是可靠的。
(2)将clk_10M 与clk_100M异步时钟处理
如果将clk_10M 与clk_100M完全看作异步时钟(假设此时这两个时钟被认为没有任何频率和相位上关系),此时处理也有如下几种办法:
-
- 如果两个时钟的频率差距较大,如本例10M/100M之间的关系,而且数据是连续传送的,及每个10M的时钟周期都有数据,此时可以利用clk_100M 的快速时钟提取慢速clk_10M 时钟的上升沿信息从而捕获tx_data. 如下面的程序所示,
reg clk_10M_r;
reg nclk_10M_r;
reg clk_10M_rg;// rg---posedge
reg [9:0] tx_data_100M;
reg tx_data_100M_vld;

always@(posedge clk_100M or posedge rst)
if(rst) begin
    clk_10M_r <= 0;
    nclk_10M_r <= 1'b1;
    clk_10M_rg <= 0;
    tx_data_100M <= 0;
    tx_data_100M_vld <= 0;
end
else begin
    clk_10M_r <= clk_10M;
    nclk_10M_r <= ~clk_10M_r;
    clk_10M_rg <= clk_10M_r & nclk_10M_r;
    tx_data_100M_vld <= 1'b0;

    if(clk_10M_rg) begin
        tx_data_100M_vld <= 1'b1;
        tx_data_100M <= tx_data;
    end
end
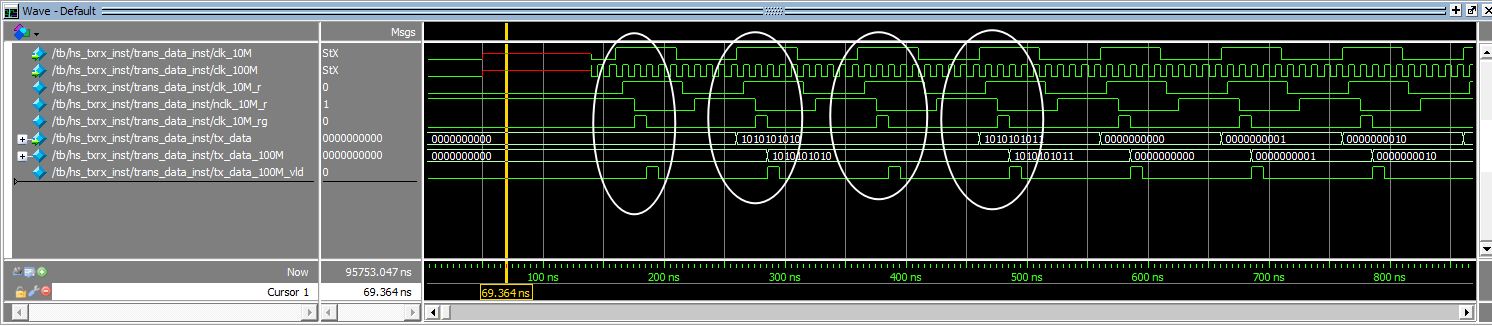
图7
图7充分利用快时钟捕获慢时钟的变化,在每个clk_10M时钟的上升沿处提取一个脉冲,脉冲宽度是clk_100M 时钟一个周期的宽度。
-
-
采用判别数据变化的方法
-
该方法在没有任何其它时钟信息可以帮助的情况下,可以方便进行异步时钟的变换。这是最普通的处理方式,由于需要多次锁存10 bits宽度的数据,因此这种处理方法也是成本最高的处理方式。基本原理如下,首先将10 M时钟同步的数据锁存两次,判断数据是否有变化,如果有变化延时采样clk_10M时钟域的数据。在数据无变化的区域默认上次采样的值,直到数据有了新的变化。
reg [9:0] tx_dra; // tx_data_ra register a
reg [9:0] tx_drb; //tx_data_rb;
reg [9:0] tx_dr;

reg tx_dr_en;
reg cmp;

always@(posedge clk_100M or posedge rst )
if(rst) begin
    tx_dra <= 0;
    tx_drb <= 0;
    tx_dr <= 0;
    cmp <= 0;
end
else begin
    tx_dra <= tx_data;
    tx_drb <= tx_dra;
    tx_dr_en <= 1'b0;

    cmp <= tx_dra != tx_drb; //compare

    if(cmp) begin
        tx_dr <= tx_data; //延时采样,
        tx_dr_en <= 1'b1;//指示采样位置
    end
end
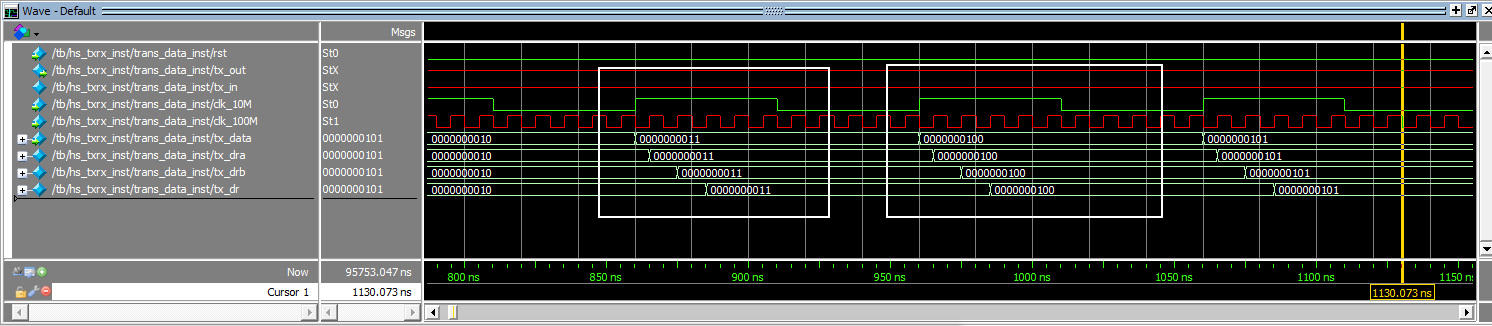
图8
上面的程序将数据锁存两次,判断数据是否有变化,如有变化将新数据锁存到tx_dr中,并用tx_dr_en指示锁存的位置。这种处理方式需要明确知道两个时钟之间频率关系,否则在长时间没有数据变化的期间,会由于频率的不确定导致失步。
-
-
利用FIFO或双口RAM(BRAM)也可以实现,但由于代价太大,这里不推荐使用。
-
本设计以判别数据变化的方法为例进行进行数据捕获与串行化处理,其它几种方法读者可以自己尝试实现。
3.数据的串行化
串行化是利用移位寄存器的方式将并行数据串行化,正是由于clk_10M 与clk_100M在频率上存在10倍关系,因此数据产生与数据消费同步或接近同步关系(如果clk_10M与clk_100M是异步时钟关系)。
always@(posedge clk_100M or posedge rst)
if(rst) begin
    tx_sft <= 0; //tx-shift
    sft_count <= 0; //shift count
end
else begin
    if(tx_dr_en) begin            //new data
        tx_sft <= tx_dr;
        sft_count <= 0;
    end
    else if(sft_count == 9) begin      //new data equal to previous data
        tx_sft <= tx_dr;
        sft_count <= 0;
    end
    else begin
        //tx_sft <= {tx_sft[8:0], tx_sft[9]} ; //new tx_sft.d[9]=old_tx_sft.q[8]
        tx_sft <= tx_sft << 1;
        sft_count <= sft_count + 1;
    end
end
上例中利用if…else if… else 具有优先级的关系,首先在clk_100M 时钟域有新的数据变化后,将新数据锁存在tx_sft中,然后开始时钟控制下左移。移位语句如下:
tx_sft <= { tx_sft[8:0], tx_sft[9] } ; //循环左移
或tx_sft <= { tx_sft[8:0], 1’b0 } ; //逻辑左移
或tx_sft <= tx_sft << 1 ; //逻辑左移
上面三种移位语句都可以实现串行化的目的,但是由于后面两种为逻辑左移,低位补零在移位时原始数据的信息丢失,需要由移位计数器标识当完成10个bits移位后需要更新移位数据,即如下程序:
else if ( sft_count == 9 ) begin
tx_sft <= tx_dr;
sft_count <= 0;
end
但是如果采用循环移位,当循环左移10次后,tx_sft又恢复到移位前的数据,如果没有新的数据数据更新,可以继续使用,因此上面的程序也可以修改为下面的等效程序。
always@(posedge clk_100M or posedge rst)
if(rst) tx_sft <= 0; //tx-shift
else begin
    if(tx_dr_en)
        tx_sft <= tx_dr;
    else
        tx_sft <= {tx_sft[8:0], tx_sft[9]} ; //new tx_sft.d[9]=old_tx_sft.q[8]
end
修改后的程序功能上没有改变但显得简洁了很多,而且综合后使用的资源也少了很多。可见FPGA程序设计在深入研究后编写的代码会处处体现一些技巧。
最后将移位寄存器的最高位tx_sft[9]赋值给tx_in并作为LVDS的输入端,tx_out是LVDS 的输出端,最终完成串行化输出,本部分程序重新列举如下:
module trans_data
(
    input  rst,
    input  clk_10M,
    input  clk_100M,

    input  [ 9: 0 ] tx_data,  // 10M的时钟对应的数据
    output tx_out
);

wire tx_in;

reg [ 9: 0 ] tx_dra; // tx_data_ra register a
reg [ 9: 0 ] tx_drb; //tx_data_rb;

reg [ 9: 0 ] tx_dr;
reg tx_dr_en;

reg [ 9: 0 ] tx_sft; //tx shift
//reg [3:0] sft_count;
reg cmp;

assign tx_in = tx_sft[ 9 ];

always@( posedge clk_100M or posedge rst )
if ( rst )
begin
    tx_dra <= 0;
    tx_drb <= 0;
    tx_dr <= 0;
    cmp <= 0;
end
else
begin
    tx_dra <= tx_data;
    tx_drb <= tx_dra;

    tx_dr_en <= 1'b0;

    cmp <= tx_dra != tx_drb; //compare

    if ( cmp )
    begin
        tx_dr <= tx_data;
        tx_dr_en <= 1'b1;
    end
end

always@( posedge clk_100M or posedge rst )
if ( rst )
    tx_sft <= 0; //tx-shift
else
begin
    if ( tx_dr_en )
        tx_sft <= tx_dr;
    else
        tx_sft <= { tx_sft[ 8: 0 ], tx_sft[ 9 ] } ; //new tx_sft.d[9]=old_tx_sft.q[8]
end

IO_TX IO_TX_inst
(
    .tx_in  ( tx_in ),
    .tx_out ( tx_out )
);

endmodule
仿真测试程序:
`timescale 1 ns / 1 ps
module tb ( );

parameter PERIOD = 20 ;          //周期20
reg pll_rst;              //实体模块PLL的rst信号
wire tx_rx;               // 收发在testbench的回环信号

wire clk_10M;
wire pll_locked;             //实体PLL锁定信号
wire rst = !pll_locked;     //Testbench内生成复位信号

reg [ 9: 0 ] tx_data;      //待发送数据

wire rx_data_vld;
wire [ 9: 0 ] rx_data;
reg inclk ;                      // 模拟板级提供的输入时钟

reg [ 2: 0 ] tx_st;

initial
begin
    inclk = 1'b0;
    #( PERIOD / 2 );
    forever
        #( PERIOD / 2 ) inclk = ~inclk;
end

//always #10 inclk = ~inclk;

initial
begin
    pll_rst = 1'b1;
    tx_data = 0;
    #50 pll_rst = 1'b0;
end

always@( posedge clk_10M or posedge rst )
if ( rst )
begin
    tx_st <= 0;
    tx_data <= 0;
end
else
begin
    case ( tx_st )
    0:
    begin
        tx_st <= 1;
        tx_data <= 0;
    end
    1:
    begin
        tx_st <= 2;
        tx_data <= 10'b10_1010_1010;
    end
    2:
    begin
        tx_st <= 3;
        tx_data <= 10'b10_1010_1010;
    end
    3:
    begin
        tx_st <= 4;
        tx_data <= 10'b10_1010_1011;
    end
    4:
    begin
        tx_st <= 5;
        tx_data <= 0;
    end
    5:
    begin
        tx_data <= tx_data + 1;
        if ( tx_data == 14 )
        begin
            tx_st <= 6;
        end
    end
    6:
    begin
        tx_st <= 1;
        tx_data <= 10'b10_1010_1010;
    end
    default:
        tx_st <= 6;
    endcase
end


hs_txrx hs_txrx_inst
(
    .inclk      ( inclk ),
    .pll_rst    ( pll_rst ),
    .tx_data    ( tx_data ),
    .tx         ( tx_rx ),
    .rx         ( tx_rx ),
    .rx_data_vld( rx_data_vld ),
    .rx_data    ( rx_data ),
    .clk_10M    ( clk_10M ),
    .pll_locked ( pll_locked )

);
endmodule
仿真波形分析:
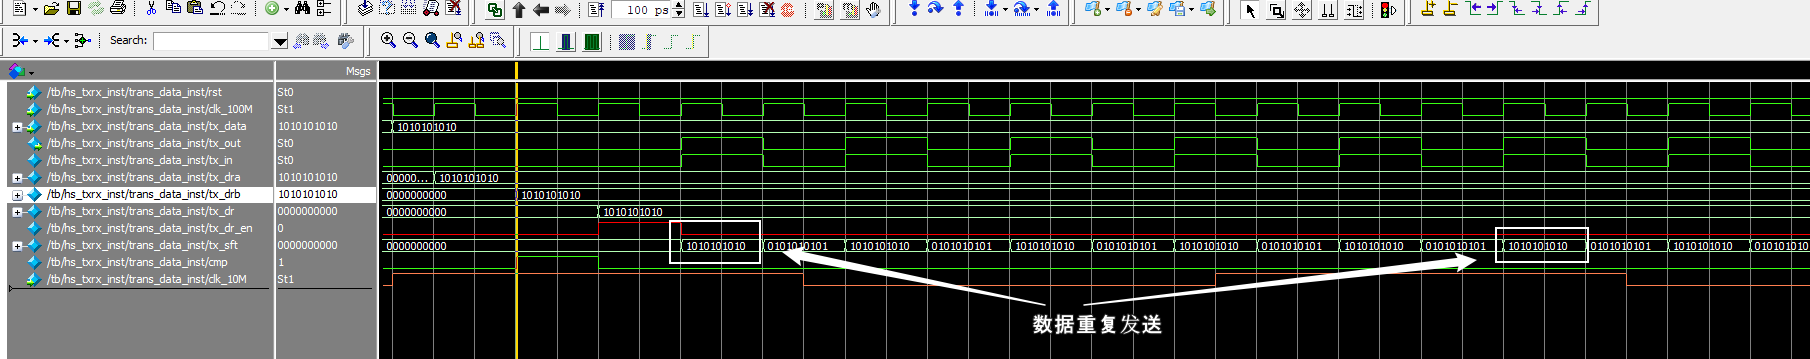
图9
从图9中可以看出,在初始化后由于原始数据都是10’b0,移位寄存器自由的移位,当第一个数据10’b10101010来临后,clk_100M捕获该数据,移位寄存器也同步调整到该数据并左移串行移位。
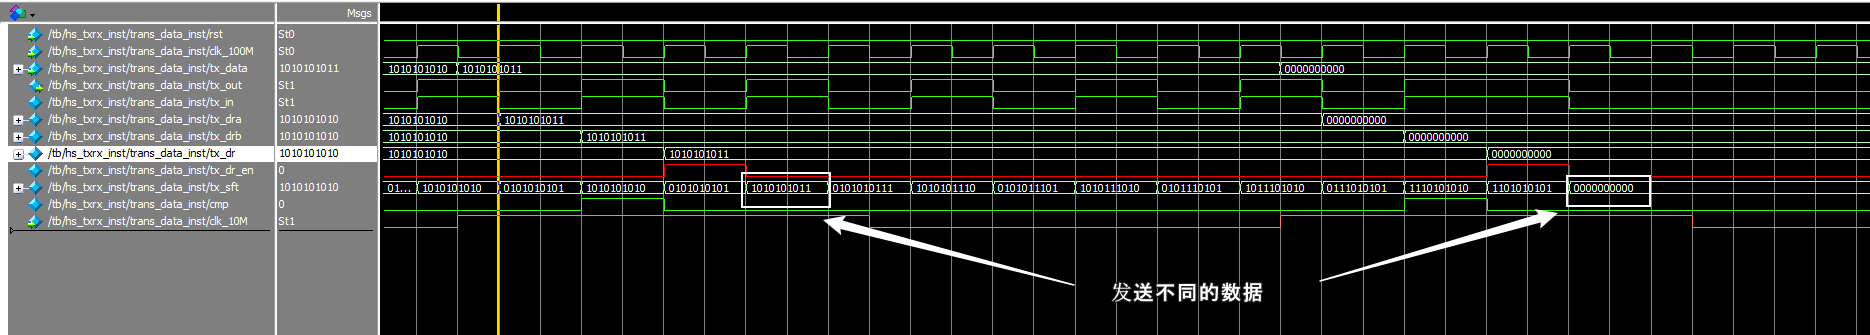
图10
图10显示,前次移位数据为10’b1010101011, 新的数据为10’b0, 如果不是新数据10’b0替代原始数据,在下次循环移位中又会恢复10’b1010101011, 并以此数据继续移位。可见利用循环左移的确以简洁的程序实现了串行左移及重复数据继续使用的特点。
图11和图12是使用逻辑左移的仿真结果。
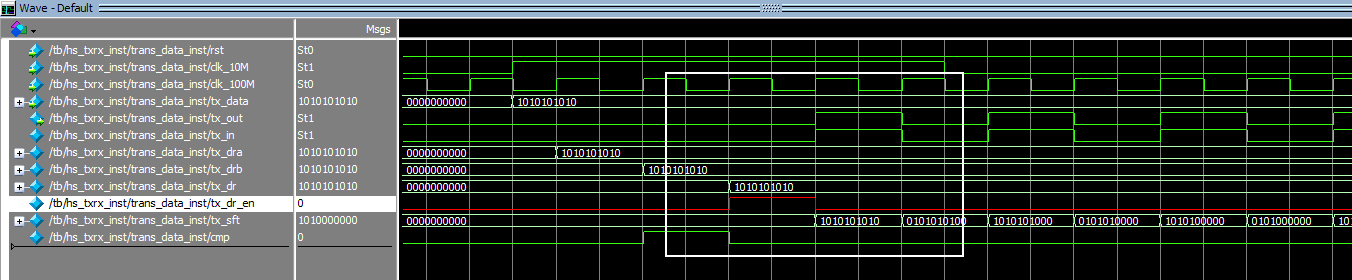
图11
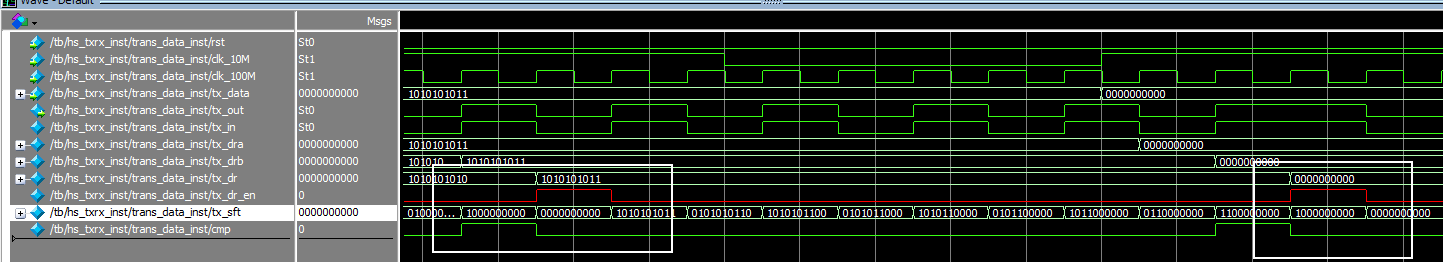
图12
总结:本文系统介绍了在通信系统中在发送通道中串行化的原理,并介绍了在不同时钟域的数据处理过程,文中列出的程序可以直接在工程中使用,或跟据需要修改后使用,也希望对将来深入学习更复杂通信协议及程序编写奠定基础。








(2)将clk_10m与clk_100m异步时钟处理中else begin clk_10m_r <= clk_10m; nclk_10m_r <=clk_10m_r;为什么仿真图里nclk_10m_r会比clk_10m_r晚一个100m的时钟?不应该在同一个时钟上升沿触发执行吗
建议阅读文章Verilog 时钟的使用及触发器模型
老师好,有两个问题。1.在把10M时钟域里的10比特数据同步到100M时钟域中时,最终的程序采用了判别数据变化的方法,但是如果10M时钟域里数据初始化是0,随着10M时钟第一个时钟周期来的第一个有效数据也是0,那么数据没有变化,100M时钟域岂不是丢掉了这个第一个有效的数据0吗?似乎应该采用提取10M时钟上升沿信息来获取数据比较稳妥。 2.并行数据串行化中没必要移位,tx_sft[n],让n变化似乎也可以
1. 如果数据不变化就使用0,因为大家都初始化为0,0就是有效数据。有效数据在接收端的PCS层有办法处理,其实我们的通信工程,的确把发送端的数据接收到了,还把有效数据提取出来了。PMA层只能发送数据,不存在有效无效,由PCS层来决定一个完整包,从而决定有效性。
2. 你说的是对的,也可以使用数组的索引,逻辑可能会大于移位寄存器的逻辑。
仿真代码中造tx_data数据的那段代码换一种写法:
initial begin
tx_data_bit(10’h1010101010);
tx_data_bit(10’h1010101010);
tx_data_bit(10’h1010101010);
tx_data_bit(10’h1010101010);
tx_data_bit(10’h1010101010);
tx_data_bit(10’h1010101010);
tx_data_bit(10’h1010101010);
tx_data_bit(10’h1010101010);
// 可以继续添加
end
task tx_data_bit(
input [9:0] data
);
integer i;
for(i=0; i<10; i=i+1) begin
case(i)
0: tx_data <= data[0];
1: tx_data <= data[1];
2: tx_data <= data[2];
3: tx_data <= data[3];
4: tx_data <= data[4];
5: tx_data <= data[5];
6: tx_data <= data[6];
7: tx_data <= data[7];
8: tx_data <= data[8];
9: tx_data <= data[9];
endcase
#(PERIOD / 2);
end
endtask
很好,鼓励探索, 不要迷信老师,和教材,同学们学习时,只要动脑筋,一定会超越老师。给陈工点赞👍!