上两节内容讲解了数据帧的概念,在发送端讲解了异步时钟的转换,由于发送端是串行化过程,所以数据往往是从低时钟域到高时钟域的转换。在接收端是过采样,串/并转换,因此时钟域的转换是从高时钟域到低时钟域的转换。时钟域的转换是必要的,有时也是必须的。
一个简单的例子是在串行高速通信中过采样时钟采用400MHz(可能会更高),在处理局部逻辑时没有问题,但如果全局采用400MHz处理复杂的逻辑或数学运算(如DSP),不仅会带来时序收敛问题,还会使FPGA或IC的功耗急剧增加,造成一系列的问题。通常降低时钟的办法有如下两种:
- 变换位宽法降低时钟频率
- 采用等位宽的方法从高时钟域到低时钟域的数据交换
下面就这两种办法分别介绍。
1. 位宽变换法
位宽变换法是指将高速低位宽的数据转换为低速高位宽的方法,利用这种方法可以降低时钟频率。在FPGA内部一般采用双口RAM(例如BRAM)或FIFO实现,典型的应用是FPGA与DDR3,DDR4读写数据时使用。举例如DDR3在800MHz双边沿读写数据时,如果DDR接口为16位,FPGA内部也采用16位,FPGA的主时钟频率将会达到1.6GHz,这在目前的主流FPGA器件上是难以实现的。但是如果将FPGA内部的位线宽度变换为128位或256位进行处理,FPGA内部时钟只需要200MHz(128位)或100MHz(256位),这部分内容在DDR3控制器一章有详细介绍。
位宽变换法在高速或超高速的通信中如万兆网或USB3.1的通信中也得到了广泛应用。其它的如图像处理,矩阵运算等方面也都应用广泛。具体做法一般用FIFO或双口RAM做桥梁,实现位宽变换,图1显示了双口RAM实现位宽变换的方式。
- 利用双口RAM实现位宽变换法
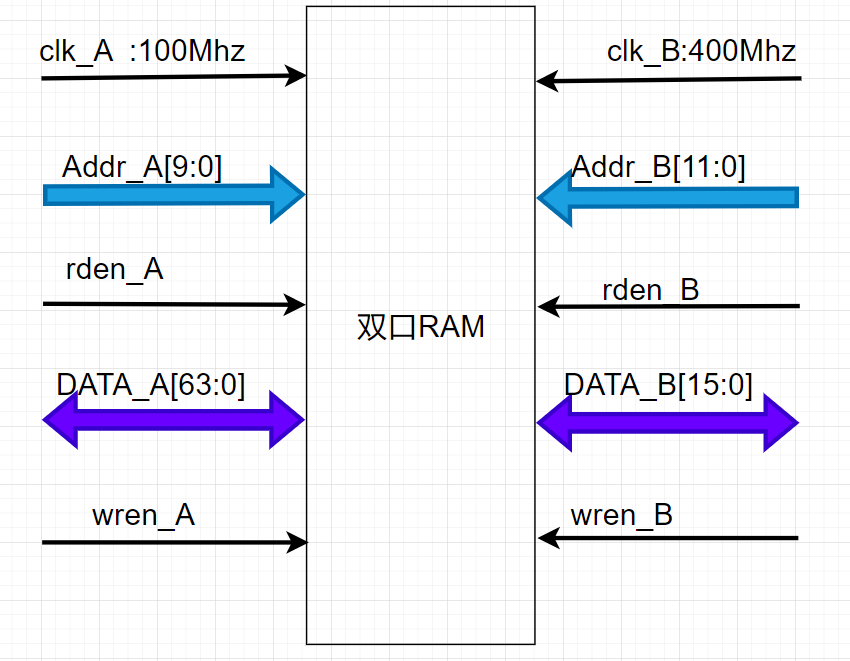
图1 利用双口RAM实现位宽变换降低时钟频率
图1中假设双口RAM的B端口为16位,读写时钟为400MHz, 如果在FPGA内对400MHz时钟的数据直接处理如数据变换(编码,分阻转发或DSP运算等)将会非常困难,但经过双口RAM变换后在A端口读出只要100MHz时钟即可,因此可以将时钟降低4倍,目前100MHz时钟对一般FPGA处理都没有压力。典型的应用是主干线为万兆网转发到多千兆网或多千兆网的数据合并到万兆网接口转发,这种口线宽度变换的方法提供非常便捷的方案(当然也可以采用DDR3/4存储器的办法实现)。在图像处理中也经常会充分利用24位(RGB)到72位变换的方法降低时钟频率。关于双口RAM做乒乓buffer的使用,后续章节会介绍。
- 利用FIFO实现位宽变换法
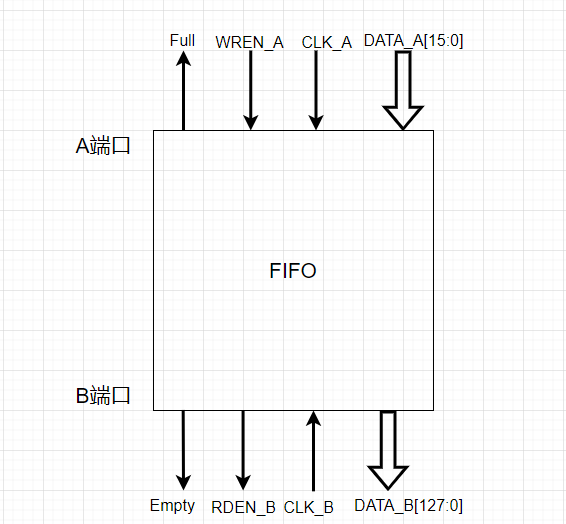
图2 利用FIFO实现位宽变换
FIFO变换的方法与双口RAM非常类似,FIFO在读写时不需要地址线,但有一点需要注意:A端口写入数据不足128-bit时,B端口会一直处于空(empty)状态,无法把数据读出,因此对不足128-bit的剩余数据处理需要进行数据填充。
在使用双口RAM或FIFO时一般除了做位宽变换,还有数据缓冲的功能,利用数据缓冲可以实现异步过程。细节请参照网络通信核DDR控制器设计等内容。
2.利用寄存器实现高速时钟域到低速时钟域的数据交换
高速时钟域到低速时钟域的数据交换一般要求两个时钟频率差别较大,一般不需要位宽变换,采用这种变换的方式代价小,处理方便,功耗低。例如串行通信中由于解调数据位的时钟频率较高,在并行化后应及时转到低时钟域进行处理,典型的如802.3Z协议1G的光纤通信的bit流为1.25G,解调的时钟为1.25G(双边沿为625MHz),当经过10b/8b变换后,实际的字节流(byte)的速率只有125MHz,因此只要利用寄存器变换即可完成。
在我们的工程中,关于快时钟到慢时钟交换数据的原理及技巧在如下步骤的处理中反映出来:
(1)高速时钟的数据和数据使能信号为rx_data,rx_data_vld,其中rx_data_vld是与过采样时钟同步的数据有效信号,脉冲宽度为过采样时钟的一个时钟周期,
(2)利用过采样时钟变换rx_data_vld到rx_data_vld_r,rx_data_vld_r信号是与单笔数据对应方波周期信号,如图3所示,
(3)利用低速时钟(如100MHz的时钟)提取rx_data_vld_r的上升沿脉冲信号rx_data_vld_xrg,
(4)根据rx_data_vld_xrg在低速时钟的上升沿对原始数据进行采样,
(5)同时生成rx_data_vld_100Mr同步脉冲信号,作为低速时钟域的数据同步指示信号,信号宽度为低速时钟的一个周期宽度,如图3所示
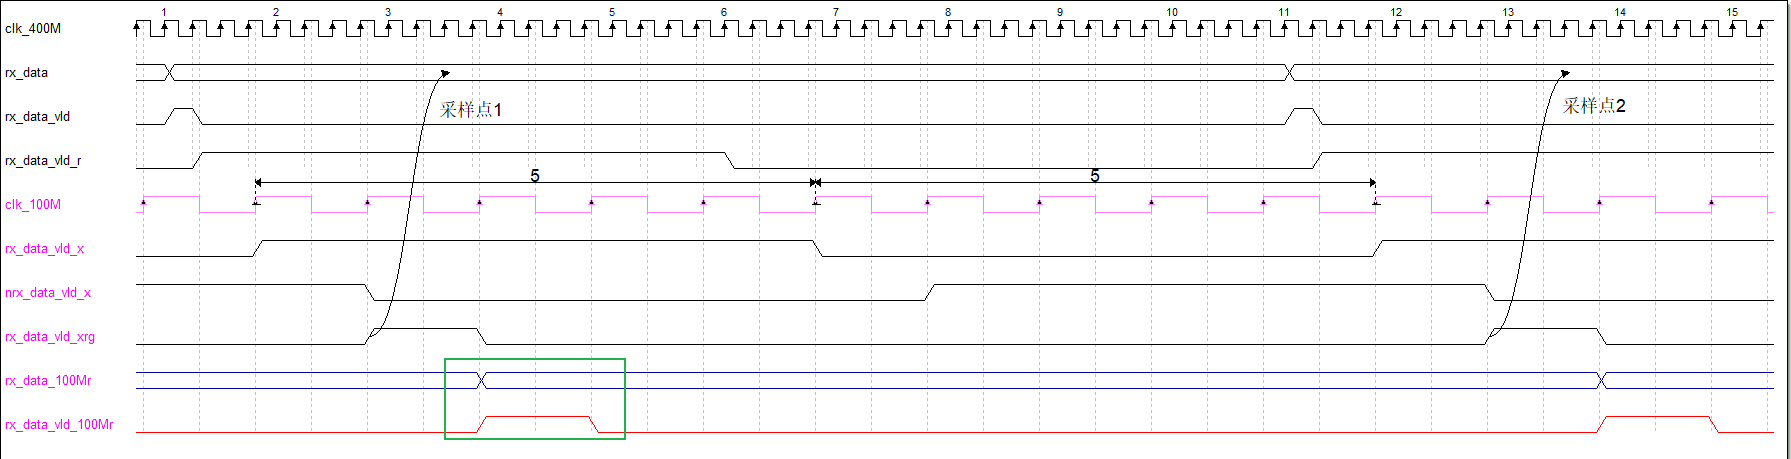
图3 高速时钟域到低速时钟域的数据交换
修改工程rx_data.v文件实现图3的功能:
module recv_data
#(
    parameter SYNC1 = 10'b1010_1010_10,
    parameter SYNC2 = 10'b1010_1010_11
)
(
    input rst,
    input clk_100M,
    input clk_400M,
    input rx,
    //output reg[9:0]       rx_data,
    //output reg        rx_data_vld
    output reg[ 9: 0 ] rx_data_100Mr,
    output reg rx_data_vld_100Mr
);


wire rx_bit;
wire rx_bit_vld;

reg [ 3: 0 ] bit_count;
reg [ 9: 0 ] bit_sft;
reg [ 9: 0 ] sync_shift = 0;

reg fr_sync1, fr_sync2;
reg fr_sync;
reg fr_end;
reg [ 7: 0 ] fr_count;

reg[ 9: 0 ] rx_data;
reg rx_data_vld_tmp;

always@( posedge clk_400M or posedge rst )

    if ( rst )
    begin
        rx_data <= 0;
        rx_data_vld_tmp <= 0;
        bit_count <= 0;
        bit_sft <= 0;
        fr_sync1 <= 0;
        fr_sync2 <= 0;
        fr_sync <= 0;
        fr_end <= 0;
        fr_count <= 0;
    end
    else
    begin
        if ( rx_bit_vld )
        begin
            bit_sft <= { bit_sft[ 8: 0 ], rx_bit };
            sync_shift <= { sync_shift[ 8: 0 ], bit_sft[ 9 ] };
        end

        if ( fr_sync )
            fr_sync2 <= 1'b0;
        else if ( bit_sft == SYNC2 )
            fr_sync2 <= 1'b1;         //fr----frame
        else
            fr_sync2 <= 1'b0;

        if ( fr_sync )
            fr_sync1 <= 1'b0;
        else if ( sync_shift == SYNC1 )
            fr_sync1 <= 1'b1;
        else
            fr_sync1 <= 1'b0;

        if ( fr_end )
            fr_sync <= 1'b0;
        else if ( fr_sync1 & fr_sync2 & rx_bit_vld )
            fr_sync <= 1'b1;

        if ( fr_sync )
        begin
            if ( rx_bit_vld )
            begin
                if ( bit_count == 9 )
                    bit_count <= 0;
                else
                    bit_count <= bit_count + 1;
            end
        end

        rx_data_vld_tmp <= 0;

        if ( bit_count == 9 )
        begin
            rx_data <= bit_sft;
            rx_data_vld_tmp <= 1'b1;
        end

        fr_end <= 1'b0;

        if ( rx_data_vld_tmp & rx_bit_vld )
            if ( fr_count == 15 )
            begin
                fr_end <= 1'b1;
                fr_count <= 0;
            end
            else
                fr_count <= fr_count + 1;
    end


wire rx_data_vld = rx_data_vld_tmp & rx_bit_vld;

reg rx_data_vld_r;
reg [ 5: 0 ] count_400M;
reg rx_data_vld_x;
reg nrx_data_vld_x;
reg rx_data_vld_xrg;

always@( posedge clk_400M or posedge rst )

    if ( rst )
    begin
        count_400M <= 0;
        rx_data_vld_r <= 0;
    end
    else
    begin
        if ( rx_data_vld )
            rx_data_vld_r <= 1'b1;
        else if ( count_400M == 19 )
            rx_data_vld_r <= 1'b0;

        if ( count_400M == 19 )
            count_400M <= 0;
        else if ( rx_data_vld_r )
            count_400M <= count_400M + 1;
    end

always@( posedge clk_100M or posedge rst )

    if ( rst )
    begin
        rx_data_vld_x <= 1'b0;
        nrx_data_vld_x <= 1'b1;

        rx_data_vld_xrg <= 1'b0;

        rx_data_100Mr <= 0;

        rx_data_vld_100Mr <= 1'b0;
//        rx_data_vld_100Mrr <= 1'b0;

    end
    else
    begin
        rx_data_vld_x <= rx_data_vld_r;
        nrx_data_vld_x <= !rx_data_vld_x;
        rx_data_vld_xrg <= nrx_data_vld_x & rx_data_vld_x;

        rx_data_vld_100Mr <= 1'b0;

        if ( rx_data_vld_xrg )
        begin
            rx_data_100Mr <= rx_data;
            rx_data_vld_100Mr <= 1'b1;
        end
    end


recv_bit recv_bit_inst
(
    .rst        ( rst ),
    .clk_400M   ( clk_400M ),
    .rx         ( rx ),
    .rx_bit     ( rx_bit ),
    .rx_bit_vld ( rx_bit_vld )

);


endmodule
顶层模块的接口也需要做相应的修改:
module hs_txrx
#(
    parameter SYNC1 = 10'b1010_1010_10,
    parameter SYNC2 = 10'b1010_1010_11
)
(
    input inclk,
    input pll_rst,

    input tx_vld,
    input tx_done,
    input [ 9: 0 ] tx_data,

    output tx,
    input rx,

    output rx_data_vld,
    output [ 9: 0 ] rx_data,

    output clk_10M,
    output pll_locked
);

wire clk_100M;
wire clk_400M;

wire rst = !pll_locked;

trans_data
#(
    .SYNC1( SYNC1 ),
    .SYNC2( SYNC2 )
)

trans_data_inst
(
    .rst        ( rst ),
    .clk_10M    ( clk_10M ),
    .clk_100M   ( clk_100M ),
    .tx_vld     ( tx_vld ),
    .tx_done    ( tx_done ),
    .tx_data    ( tx_data ),    // 10M的时钟对应的数据
    .tx_out     ( tx )
);

recv_data
#(
    .SYNC1( SYNC1 ),
    .SYNC2( SYNC2 )
)
recv_data_inst
(
    .rst                  ( rst ),
    .clk_100M             ( clk_100M ),
    .clk_400M             ( clk_400M ),
    .rx                   ( rx ),
    .rx_data_100Mr        ( rx_data ),
    .rx_data_vld_100Mr    ( rx_data_vld )

);

pll1 pll1_inst
 (
    .areset ( pll_rst ),    //1'b0;
    .inclk0 ( inclk ),
    .c0     ( clk_10M ),
    .c1     ( clk_100M ),
    .c2     ( clk_400M ),
    .locked ( pll_locked )

 );


endmodule
由于这里的信号变换比较简单,文章中就不再仿真,如果想得到验证,可以根据修改后的工程自行仿真或观看对应视频(视频中有仿真部分的内容)。







