在数据处理的过程中,数据的生产者与数据的消费者一般情况下不能在速度上匹配,这就产生了异步过程。异步过程无论在通信,图像处理及其它与数据处理相关的领域都是普遍存在的现象。不仅FPGA的设计者要处理异步过程,软件开发工程师同样面临异步过程的处理。下文首先分析异步过程产生的原因以及针对不同原因提出不同的解决办法。产生异步过程的原因有如下几种情况:
1. 产生异步过程的原因
-
过程不同步
过程不同步是最常见的一种异步过程,主要原因是数据的使用者当前有多个任务需要处理,目前正在处理其他事务,对当前的数据只能缓存;直到调度系统可以安排使用者进程(或线程)处理该数据时,才有机会处理缓存中的数据。图1显示异步过程中的过程不同步示例。
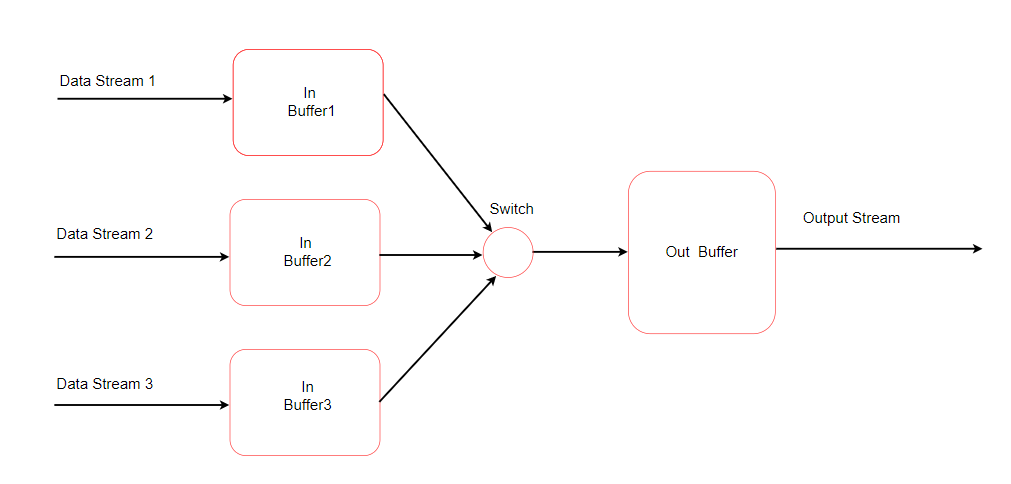
图1 过程数据缓存
图1中可以看到,在一个系统中有4个数据的处理过程,3个数据流(Data Stream)的数据输入,一个Data Stream的输出,Data Stream 可能是并行数据,也可能是串行数据。这个过程在是比较常见的过程,比如3个千兆网的输入数据汇集后由万兆网发出,由于网络发送是按照数据包的方式转发,假设当前输出正在转发Data Stream1(Data Stream1 可能1500 Bytes), 当数据转发完一个数据包后, 切换到Data Stream2,如果Data Stream2没有数据缓冲,可能会引起数据丢失。因此在数据链路中加上输入数据缓冲是必要的。这种情况同样适用于多摄像头图像数据缓存(如图像存入DDR3/4中)和图像转发的情况。
-
速度或时间上不匹配
有结构的数据往往在数据传送和存储时有特殊要求。如图像数据是按照帧组织的,每一帧数据又分为行和列(如分辨率为1920 X 1080 ,1920列,1080行),行与行之间有黑场,帧与帧之间也有黑场。当摄像头的帧起始与显示器的帧起始不同步时或行不同步时就需要行缓冲或帧数据缓冲(时间上不匹配)。
-
- 帧起始不同步:例如摄像头每秒钟30帧图像,而显示器一般都是60帧以上的刷新率,因此显示器就需要将上一帧图像进行缓冲,以便下一帧显示时重复上一帧的数据。
- 行不同步:行不同步是指行的起始点不同。例如摄像头有一行新数据需要显示,但显示器正处在黑场期间,不能使用传来的图像数据,因此只能先缓冲后使用。
网络传输存在同样的问题,如百兆网的数据传输速度是千兆网的1/10,但网络包数据是有结构的,如果不先缓冲,千兆转发时会引起数据包中丢失或重复(速度上不匹配)。
-
数据必须按一定的结构使用
有时数据要求必须按一定的结构使用,在这种情况下,必须存储一定数量的数据才能一起使用。例如在数字信号处理中的FIR滤波器一般需要n个数据,如图2
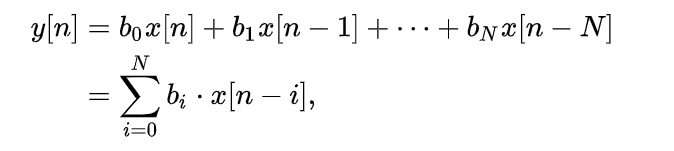
图2 Fir滤波器的卷积公式
图2在计算y[n]时,y[n]不仅与当前的输入x[n]有关,还与x[n]之前的数据x[n-1]…x[n-N]有关。因此在利用图2计算y[n] 时需要预存储的数据。所以数据必须要使用Buffer进行缓存,不能以数据流的方式处理。
-
接口不匹配
这种情况一般发生在数据接收端,可能是通信,也可能是数据采样等(与摄像头的数据)。由于数据具有高速,突发的特点,导致数据使用者无法直接处理数据,因此需要硬件逻辑和存储器缓冲,否则会引起数据丢失。
例如在本章讲解的串行高速通信的接收部分送给应用层的数据,虽然接口层有rx_data_vld,rx_data_rdy等握手信号,但如果交给CPU处理,往往CPU没有该类信号的接口,即使有该接口,CPU软件也不适合处理这种类型的数据。
再举个简单的例子,CPU往往是多任务系统,如果CPU不在当前的调度过程中,接收端即使收到数据,也往往会丢失。如果照顾每一个byte的数据,CPU的时间将会被接收数据牢牢占用,不可能再有时间处理其它过程,因为接收端数据具有高速,突发的特点,CPU将会随时监控数据的来临(当然这只是假设CPU有能力接收每一byte的数据)。在系统设计中往往不是使用这种方法,接收端通常加数据缓冲器来接收数据。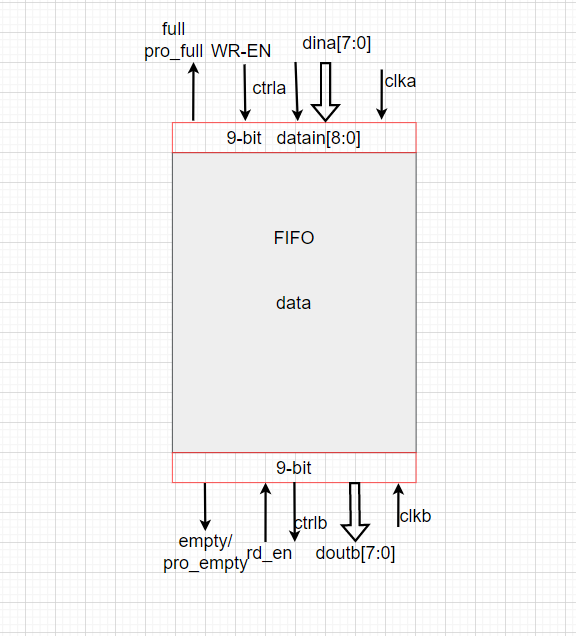
2. 异步过程的处理办法
异步过程与异步时钟域不同,异步时钟域需要确保在不同时钟采样时的安全性,比如亚稳态,setup和hold的时间等,安全的将数据从一个时钟域交换的另一个时钟域。但异步过程是对突发性数据的处理,即使在同步时钟下也照常发生。当然在数据处理上往往可能既会有异步时钟的转换,也会有异步过程需要处理。一般处理办法如下:
- 计算机内存缓冲
在计算机的数据处理过程中一般会在内存开辟一块空间(DDR3/4)用于数据缓存,实现数据共享。比如USB,PCIE,网络数据等。当然在处理每笔交易时,还会有每笔交易的独享缓存,比如PCIE的交易或USB的交易都会有自己的数据缓存,这些缓存多数都是FIFO(First In, First Out)或双口RAM实现的,如图3所示。
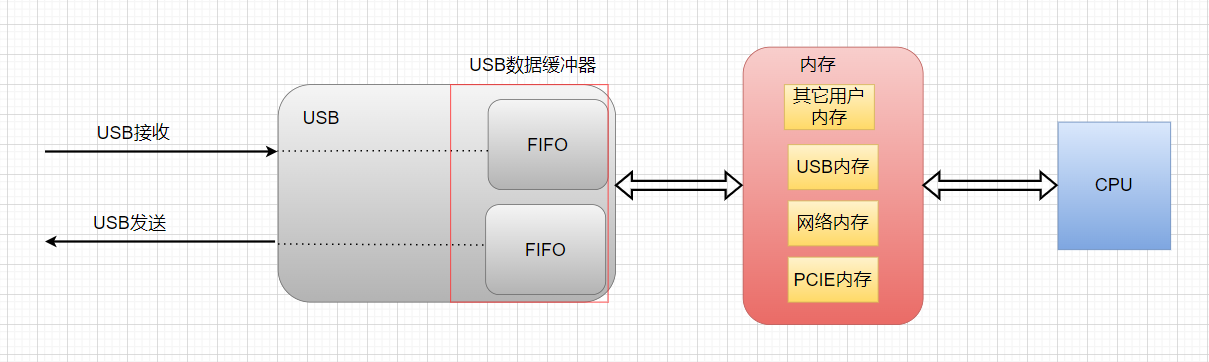
图3
- FIFO缓冲异步过程
正如图3所示,当数据的缓存需求较小或仅仅是缓冲局部交易时可以选用FIFO。如果既有异步时钟域转换又有异步过程的需求,FIFO也是一个不错的选择。
-
- FIFO对数据包的隔离
一般使用FIFO时,多数是用来缓冲数据包的,但如果只是对于同步时钟下或读写时钟频率不高的数据,可以通过通信双方握手实现FIFO里仅存一个数据包的深度(如准双工通信),此时主要控制FIFO的空满,不会因为满(full)而丢数据,也不会因为空(empty)而读出重复数据。如果使用异步时钟或读写时钟频率很高时(如300M以上),建议在读数据端口加一级latency优化时序,同时为了确保full与empty可控建议使用可编程空(prog_empty)和可编程满(prog_full),如图4所示。
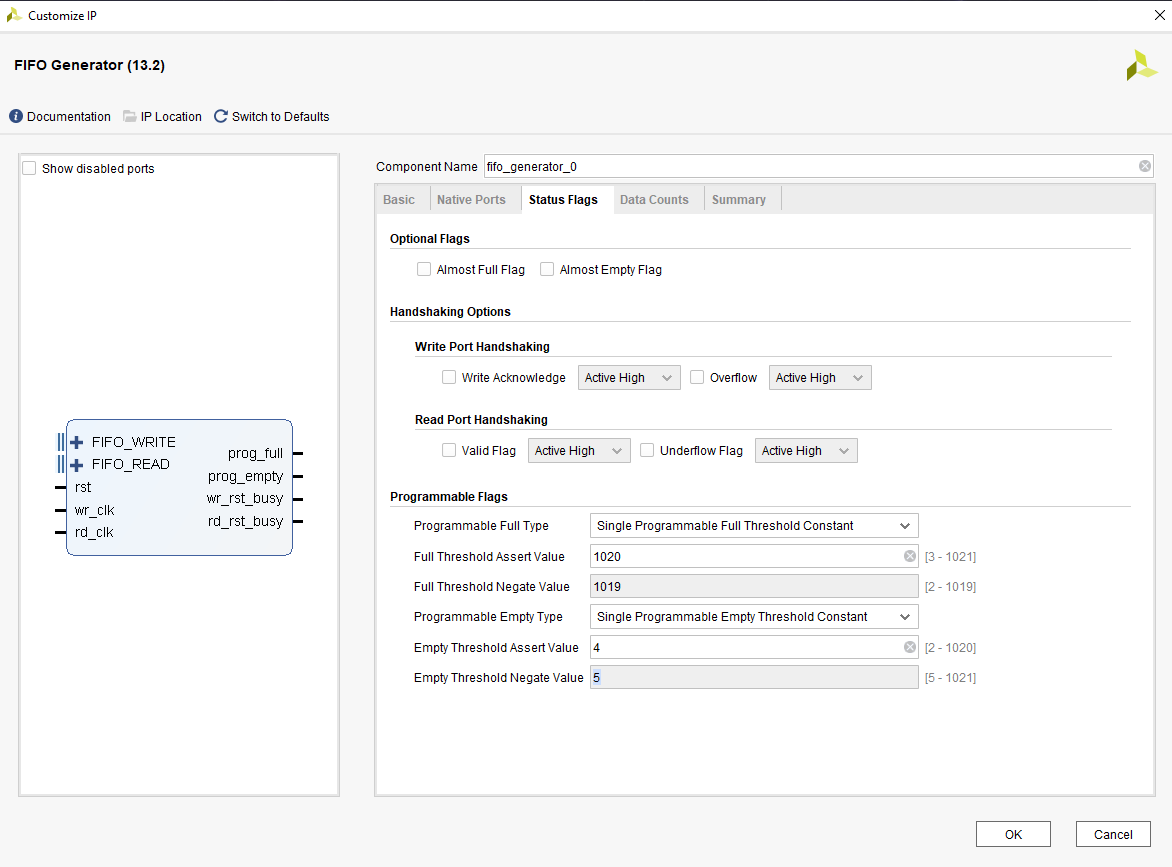
图4:
如果想利用FIFO缓冲多个数据包,应注意隔段的设置。设置技巧如下:
一般内部的BRAM都是9k-bit为单位组织的,可以配置成9k-1bit,4096-2bit,3k-3bit,1k-9bit,512-18bit,256-36bit等结构形式,如果深度不够,可以两个或多个BRAM级联,只要在利用向导配置FIFO时选择特定的深度,Vivado 或Quartus工具可以自动实现多BRAM的级联(注:如果宽度和深度都较小时也可选择distributed RAM, 利用FPGA内部的LUT实现)。可见对于8-bit的数据可以利用8-bit(数据) + 1-bit(控制字,ctrl)的结构对FIFO读写。
注:Xilinx一般以18k-bit为单位组织的。
图5 9-bit结构 FIFO
采用9-bit结构的接口,可以很好的将数据包进行分割。
例1: 针对串行高速通信的数据包,利用FIFO进行缓冲,假设FIFO有足够的深度,利用9-bit的结构将数据包在FIFO内分割,并统计FIFO内当前数据包的数量。为了保证数据包的完整性,要求FIFO内至少有一个完整的数据包后再读取。设计异步时钟的数据处理过程。FIFO的命名采用图6给出的名称。
(1)在Vivado环境下例化9-bit FIFO
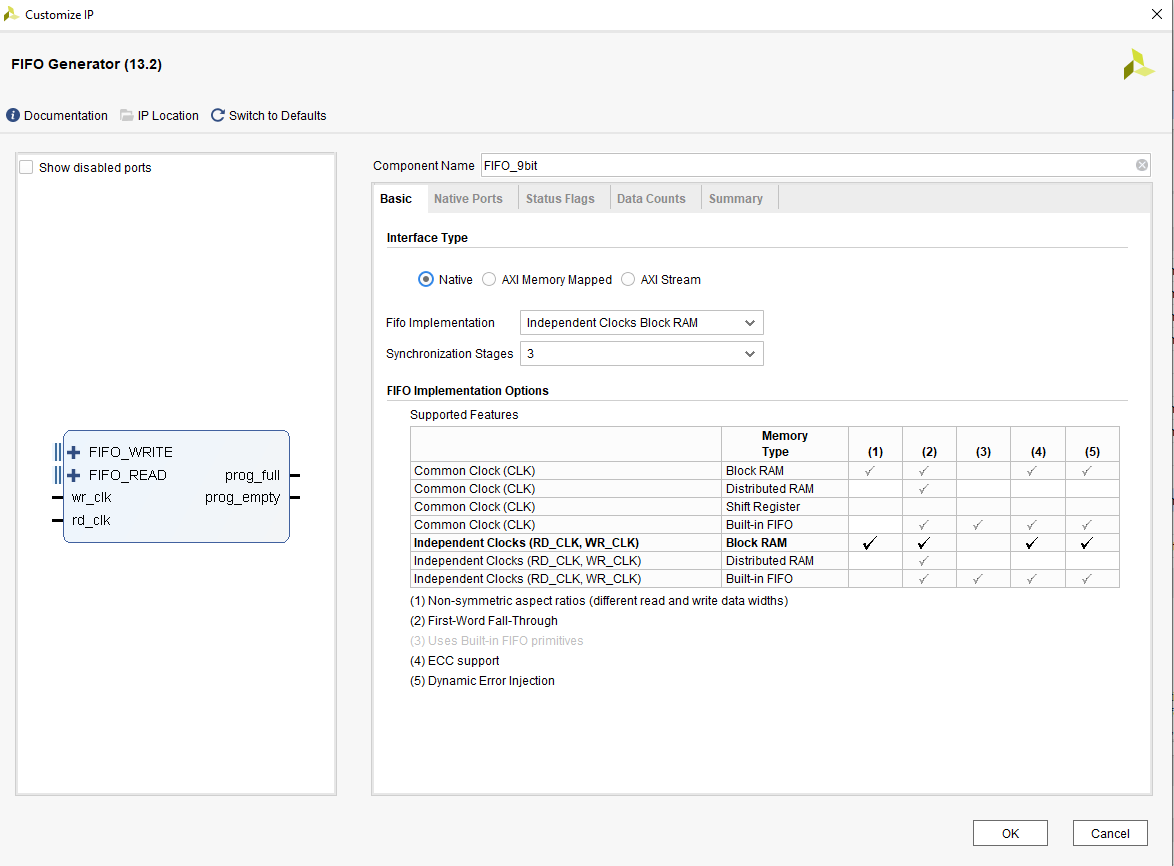
图6
图6中,采用传统的FIFO(native)的接口例化方式,如果熟悉AXI总线,也可以选择AXI stream的接口方式。采用分离的时钟,作为两个异步时钟域过程的桥梁。同步synchronization stage,可以设为2或3,当两边的时钟频率较高时,可以将该值设的大一点。这里设为3(仅是举例说明,本设计中2即满足要求)。
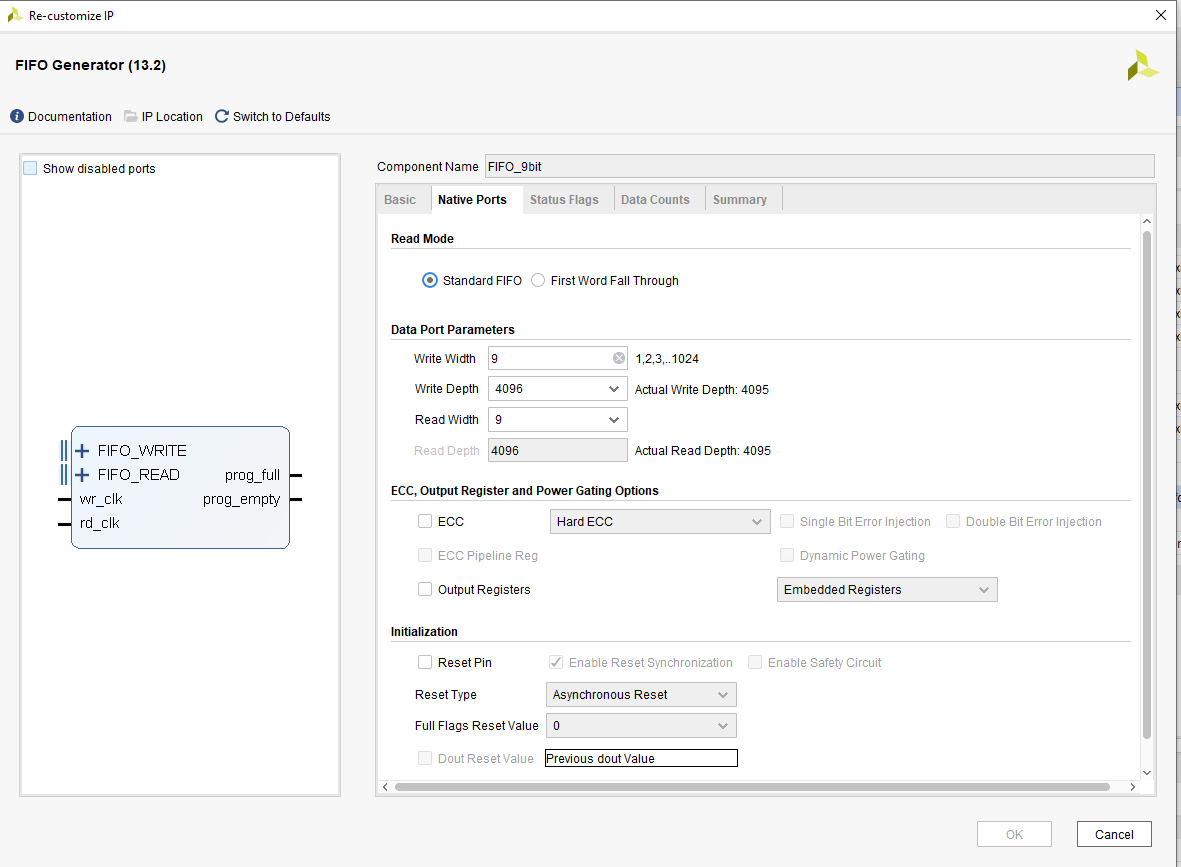
图7
图7中设置为9-bit的读写宽度,4096的深度。
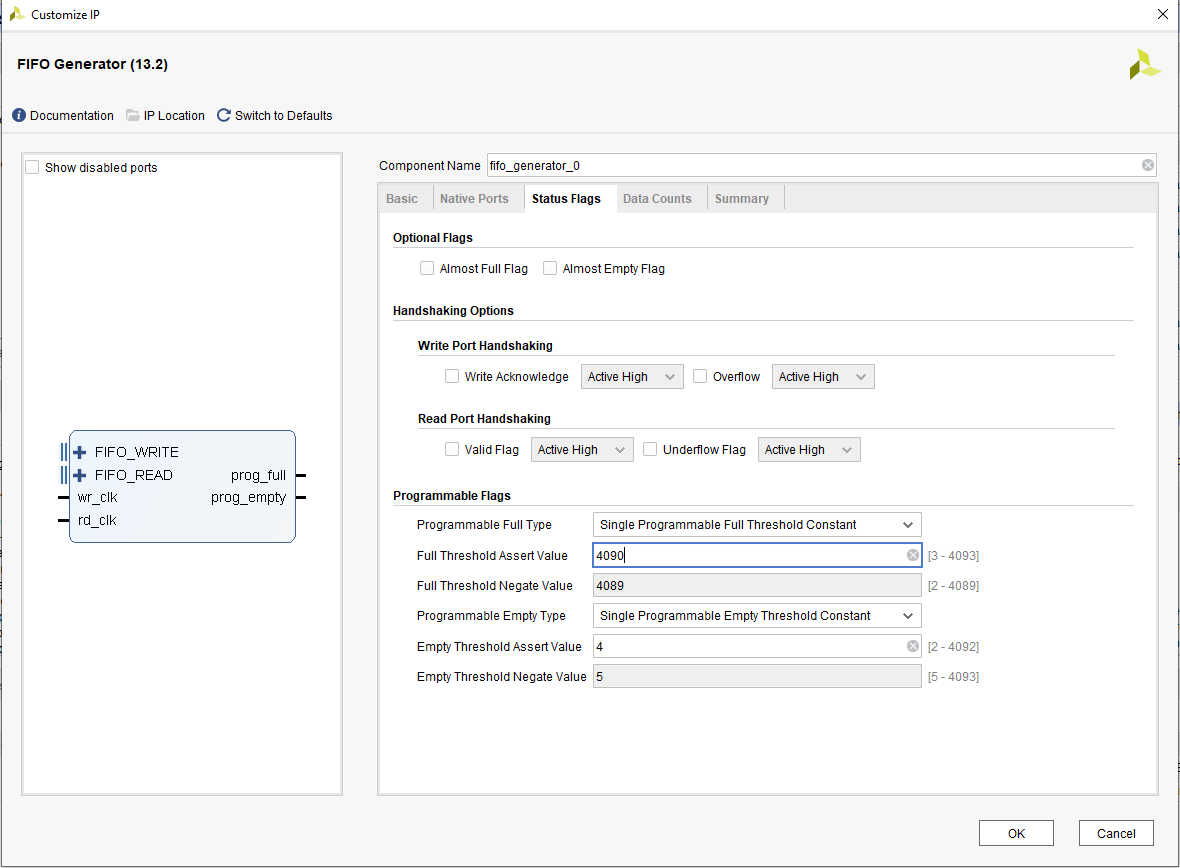
图8
图8中设置可编程满或空,按照项目的实际需求设定上/下限(一般称为water mark)。其它按照缺省值设定,生成IP 核并例化。
(2)Vivado接收数据写Verilog代码
[content_control]
module recv_fifo_rd_wr
(
    input  rd_clk,
    input  wr_clk,
    input  clk_400M,
    input  rx,
    input  rst,

    input  app_rd_en,
    output [ 8: 0 ] app_rd_data,
    input  pac_minus,
    output reg[ 7: 0 ] packets_count = 0,
    output fifo_prog_empty

);

localparam IDLE = 10'b10_1010_1010;

wire rx_data_vld;
wire [ 7: 0 ] rx_data;
wire rx_rdy;

reg fifo_wr_en = 0;
wire [ 8: 0 ] fifo_din;
reg [ 7: 0 ] wr_data = 0;
reg wr_ctrl_bit = 0;

reg pac_plus = 0;
wire prog_full;

assign fifo_din = { wr_ctrl_bit, wr_data };

reg [ 3: 0 ] wr_st = 0;


reg pkg_vld = 0;
always@( posedge wr_clk or posedge rst )
    if ( rst )
    begin
        pkg_vld <= 0;
        wr_st <= 0;
        wr_data <= 0;
        wr_ctrl_bit <= 0;
        fifo_wr_en <= 0;
    end
    else
    case ( wr_st )
        0:
        begin
            pkg_vld <= 0;
            wr_data <= 0;
            wr_ctrl_bit <= 0;
            fifo_wr_en <= 0;

            if (~(rx_data_vld | prog_full) )
                wr_st <= 1;
        end
        1:

        begin
            pkg_vld <= 1;
            wr_data <= 0;
            wr_ctrl_bit <= 0;

            if ( rx_data_vld )
            begin
                wr_ctrl_bit <= 1'b1;
                fifo_wr_en <= 1'b1;
                wr_st <= 2;
            end
        end
        2:
        begin
            wr_ctrl_bit <= 1'b0;
            fifo_wr_en <= 1'b0;

            if ( ~rx_data_vld )
            begin
                wr_st <= 3;
            end
            else if ( rx_rdy )
            begin
                wr_data <= rx_data;
                fifo_wr_en <= 1'b1;
            end
        end
        3:
        begin
            wr_ctrl_bit <= 1'b1;
            wr_data <= 8'hff;
            fifo_wr_en <= 1'b1;
            wr_st <= 0;
        end
        default:
            wr_st <= 0;

    endcase

reg [ 2: 0 ] rx_data_vld_x = 0;  //x designated for cross clock domain;
always@( posedge rd_clk or posedge rst )
    if ( rst )
    begin
        pac_plus <= 1'b0;
        rx_data_vld_x <= 0;
    end
    else
    begin
        pac_plus <= 1'b0;
        rx_data_vld_x <= {rx_data_vld_x[1:0], rx_data_vld & pkg_vld};


        if ( rx_data_vld_x[ 2: 1 ] == 2'b10 ) // package end
            pac_plus <= 1'b1;
    end


always@( posedge rd_clk or posedge rst )
    if ( rst )
    begin
        packets_count <= 0;
    end
    else
    begin
        packets_count <= packets_count + pac_plus - pac_minus;
    end

fifo_9bit fifo_9bit_inst
(
    .wr_clk     ( wr_clk ),
    .wr_en      ( fifo_wr_en ),
    .din        ( wr_data ),
    .full       (),
    .prog_full  ( prog_full ),

    .rd_clk     ( rd_clk ),
    .rd_en      ( app_rd_en ),
    .dout       ( app_rd_data ),
    .empty      (),
    .prog_empty ( fifo_prog_empty )
);


rx_phy #
(
    .IDLE( IDLE )
)
rx_phy_inst
(
    .clk_100M   ( wr_clk ),
    .clk_400M   ( clk_400M ),
    .rx         ( rx ),
    .rst        ( rst ),

    .rx_data_vld( rx_data_vld ),
    .rx_data    ( rx_data ),
    .rx_rdy     ( rx_rdy )

);

endmodule
[/content_control]
上面的Verilog 代码采用9’b1_0000_0000做为包起始标志,9’b1_1111_1111作为包结束标志,可以在APP 端读出时,清晰知道包的分隔,即如果FIFO数据是由多个数据包组成,APP在使用可以利用这些标志知道一个包的首尾。 同时上面的程序还对FIFO存储的包的数量进行统计,为APP层使用FIFO的策略提供明确依据。这段代码将会成为data_link层代码的一个部分。
(3) APP层 Verilog 代码
[content_control]
module rx_app
(
    input wr_clk,
    input rd_clk,
    input clk_400M,
    input rst,
    input rx,

    input rd_vld,
    output reg[ 7: 0 ] app_data,
    output reg app_rdy,
    output reg last
);

wire fifo_prog_empty;
wire [ 7: 0 ] packets_count;
wire [ 8: 0 ] app_rd_data;
reg app_rd_en;
reg pac_minus;

reg [2:0] rd_st;

always@( posedge rd_clk or posedge rst )
    if ( rst )
    begin
        app_rd_en <= 0;
        pac_minus <= 0;
        app_rdy <= 0;
        app_data <= 0;
        last <= 0;
        rd_st <= 0;
    end
    else
    case ( rd_st )
        0:
        begin
            app_rd_en <= 0;
            pac_minus <= 0;
            app_rdy <= 0;
            app_data <= 0;
            last <= 0;

            if ( !fifo_prog_empty )
                rd_st <= 1;
        end

        1:
        begin
            app_rd_en <= 0;
            pac_minus <= 0;
            last <= 0;

            if ( packets_count != 0 )
            begin
                app_rd_en <= 1'b1;
                rd_st <= 2;
            end
        end

        2:
        begin
            app_rd_en <= 1'b0;
            rd_st <= 3;
        end

        3:
        begin
            app_rd_en <= 1'b0;

            if ( !app_rd_data[ 8 ] )
            begin
                app_data <= app_rd_data[ 7: 0 ];
                rd_st <= 4;
            end
            else
            begin
                app_rd_en <= 1'b1;
                rd_st <= 2;
            end
        end

        4:
        begin
            if ( rd_vld )
            begin
                app_rdy <= 1'b1;
                app_rd_en <= 1'b1;
                rd_st <= 5;
            end
        end

        5:
        begin
            app_rdy <= 1'b0;
            app_rd_en <= 1'b0;
            rd_st <= 6;
        end

        6:
        begin
            if ( app_rd_data[ 8 ] )
            begin
                last <= 1'b1;
                pac_minus <= 1;
                rd_st <= 7;
            end
            else
            begin
                app_data <= app_rd_data[ 7: 0 ];
                rd_st <= 4;
            end
        end

        7:
        begin
            pac_minus <= 0;
            last <= 1'b0;
            rd_st <= 0;
        end

        default:
            rd_st <= 0;

    endcase


recv_fifo_rd_wr recv_fifo_rd_wr_inst
(
    .rd_clk         ( rd_clk ),
    .wr_clk         ( wr_clk ),
    .clk_400M       (clk_400M),
    .rst            ( rst ),
    .rx             ( rx ),
    .app_rd_en      ( app_rd_en ),
    .app_rd_data    ( app_rd_data ),
    .pac_minus      ( pac_minus ),
    .packets_count  ( packets_count ),
    .fifo_prog_empty( fifo_prog_empty )

);


endmodule
[/content_control]
虽然APP 层的写代码,看起来与data_link(recv_fifo_rd_wr)层的读接口协议类似,但是已经成功交换到应用层的读写接口,此时可以按照总线协议的方式读取,如ARM CPU 的AXI lite/full/stream的方式读写。
当有端口变换需求时,也可以利用控制字的方式。例如在数据输入端为8位,当数据输出为32位时,可以在8位输入端利用控制字做填充实现8-bit到32-bit端口的对齐。
例2, 利用填充实现FIFO从8位到32位对齐的读写。
将例1的代码进行修改,接收数据端保持8-bit不变,输出端口为36-bit,实现当数据包中的数据不是4的整数倍时,对FIFO写入端进行填充,使FIFO读出端口不会因为空(empty)而阻止数据读出。
注:当在FIFO的32-bit端口读数据时,如果FIFO内不足4个字节,则显示为空,即不能读出FIFO内剩余的字节。
FPPGA内的FIFO配置如图9所示,
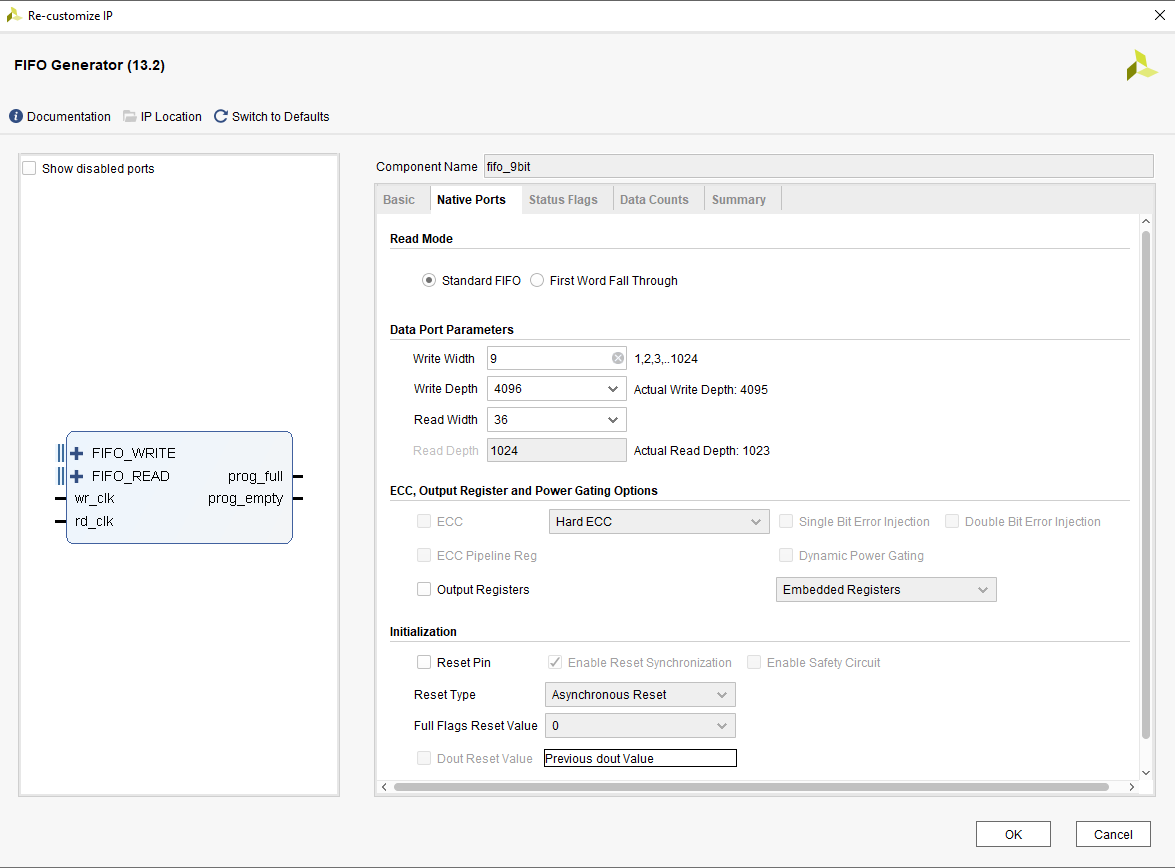
图9
图9 写入为9-bit接口,读出为36-bit接口。其它的按照例1的值设定。重新例化FIFO。
将例1的源程序修改如下:
module recv_fifo_rd_wr
(
    input  rd_clk,
    input  wr_clk,
    input  clk_400M,
    input  rx,
    input  rst,

    input  app_rd_en,
    output [ 35: 0 ] app_rd_data,
    input  pac_minus,
    output reg[ 7: 0 ] packets_count = 0,
    output fifo_prog_empty

);
wire rx_data_vld;
wire [ 7: 0 ] rx_data;
wire rx_rdy;

reg fifo_wr_en = 0;
wire [ 8: 0 ] fifo_din;
reg [ 7: 0 ] wr_data = 0;
reg wr_ctrl_bit = 0;

reg pac_plus = 0;
reg [ 1: 0 ] wr_byte_count;

reg pkg_vld = 0;

wire prog_full;

assign fifo_din = { wr_ctrl_bit, wr_data };

reg [ 3: 0 ] wr_st = 0;


always@( posedge wr_clk or posedge rst )

    if ( rst )
    begin
        wr_st <= 0;
        wr_data <= 0;
        wr_ctrl_bit <= 0;
        fifo_wr_en <= 0;
        wr_byte_count <= 0;
        pkg_vld <= 0;
    end
    else
    case ( wr_st )
        0:
        begin
            wr_byte_count <= 0;
            wr_data <= 0;
            wr_ctrl_bit <= 0;
            fifo_wr_en <= 0;
            pkg_vld <= 0;

            if (~(rx_data_vld | prog_full) )
                wr_st <= 1;
        end
        1:
        begin
            wr_data <= 0;
            wr_ctrl_bit <= 0;
            pkg_vld <= 1;

            if ( rx_data_vld )
            begin
                wr_ctrl_bit <= 1'b1;
                fifo_wr_en <= 1'b1;
                wr_st <= 2;
            end
        end
        2:
        begin
            wr_st <= 3;
        end
        3:
        begin
            wr_st <= 4;
        end
        4:
        begin
            wr_st <= 5;
        end
        5:
        begin
            wr_ctrl_bit <= 1'b0;
            fifo_wr_en <= 1'b0;

            if ( ~rx_data_vld )
            begin
                wr_st <= 6;
            end
            else if ( rx_rdy )
            begin
                wr_data <= rx_data;
                fifo_wr_en <= 1'b1;
                wr_byte_count <= wr_byte_count + 1;
            end
        end
        6:
        begin
            fifo_wr_en <= 1'b0;

            if ( wr_byte_count == 0 )
                wr_st <= 9;
            else
            begin
                wr_ctrl_bit <= 1'b1;
                wr_data <= 8'h55;
                fifo_wr_en <= 1'b1;
                wr_st <= 7;
            end
        end
        7:
        begin
            fifo_wr_en <= 1'b0;

            if ( wr_byte_count == 3 )
                wr_st <= 9;
            else
            begin
                wr_ctrl_bit <= 1'b1;
                wr_data <= 8'h55;
                fifo_wr_en <= 1'b1;
                wr_st <= 8;
            end
        end
        8:
        begin
            fifo_wr_en <= 1'b0;

            if ( wr_byte_count == 2 )
                wr_st <= 9;
            else
            begin
                wr_ctrl_bit <= 1'b1;
                wr_data <= 8'h55;
                fifo_wr_en <= 1'b1;
                wr_st <= 9;
            end
        end
        9:
        begin
            wr_ctrl_bit <= 1'b1;
            wr_data <= 8'hff;
            fifo_wr_en <= 1'b1;
            wr_st <= 10;
        end
        10:
        begin
            wr_ctrl_bit <= 1'b1;
            wr_data <= 8'hff;
            fifo_wr_en <= 1'b1;
            wr_st <= 11;
        end
        11:
        begin
            wr_ctrl_bit <= 1'b1;
            wr_data <= 8'hff;
            fifo_wr_en <= 1'b1;
            wr_st <= 12;
        end
        12:
        begin
            wr_ctrl_bit <= 1'b1;
            wr_data <= 8'hff;
            fifo_wr_en <= 1'b1;
            wr_st <= 0;
        end

        default:
            wr_st <= 0;

    endcase

reg [ 2: 0 ] rx_data_vld_x = 0;  //x designated for cross clock domain;


always@( posedge rd_clk or posedge rst )
    if ( rst )
    begin
        pac_plus <= 1'b0;
        rx_data_vld_x <= 0;
    end
    else
    begin
        pac_plus <= 1'b0;
        rx_data_vld_x <= {rx_data_vld_x[1:0], rx_data_vld & pkg_vld};

        if ( rx_data_vld_x[ 2: 1 ] == 2'b10 )
            pac_plus <= 1'b1;
    end


always@( posedge rd_clk or posedge rst )

    if ( rst )
    begin
        packets_count <= 0;
    end
    else
    begin
        packets_count <= packets_count + pac_plus - pac_minus;
    end

//fifo_9bit  fifo_9bit_inst
//(
//.wr_clk    (wr_clk),
//.wr_en     (fifo_wr_en),
//.din       (fifo_din),
//.full      (),
//.prog_full (prog_full),

//.rd_clk    (rd_clk),
//.rd_en     (app_rd_en),
//.dout      (app_rd_data),
//.empty     (),
//.prog_empty(prog_empty)
//);


fifo_9_32 fifo_9_32_inst
(
    .wr_clk         ( wr_clk ),
    .wr_en          ( fifo_wr_en ),
    .din            ( fifo_din ),
    .full           (),
    .prog_full      ( prog_full ),

    .rd_clk         ( rd_clk ),
    .rd_en          ( app_rd_en ),
    .dout           ( app_rd_data ),
    .empty          (),
    .prog_empty     ( fifo_prog_empty )
);

rx_phy #
(
    .IDLE( IDLE )
)
rx_phy_inst
(
    .clk_100M   ( wr_clk ),
    .clk_400M   ( clk_400M ),
    .rx         ( rx ),
    .rst        ( rst ),

    .rx_data_vld( rx_data_vld ),
    .rx_data    ( rx_data ),
    .rx_rdy     ( rx_rdy )

);

endmodule
rx_app.v:
module rx_app
(
    input wr_clk,
    input rd_clk,
    input clk_400M,
    input rst,
    input rx,

    input rd_vld,
    output reg[ 35: 0 ] app_data,
    output reg app_rdy,
    output reg last

);

wire fifo_prog_empty;
wire [ 7: 0 ] packets_count;
wire [ 35: 0 ] app_rd_data;
reg app_rd_en;
reg pac_minus;

reg [2:0] rd_st;

always@( posedge rd_clk or posedge rst )

    if ( rst )
    begin
        app_rd_en <= 0;
        pac_minus <= 0;
        app_rdy <= 0;
        app_data <= 0;
        last <= 0;
        rd_st <= 0;
    end
    else
    case ( rd_st )
        0:
        begin
            app_rd_en <= 0;
            pac_minus <= 0;
            app_rdy <= 0;
            app_data <= 0;
            last <= 0;

            if ( !fifo_prog_empty )
                rd_st <= 1;
        end

        1:
        begin
            app_rd_en <= 0;
            pac_minus <= 0;
            last <= 0;

            if ( packets_count != 0 )
            begin
                app_rd_en <= 1'b1;
                rd_st <= 2;
            end
        end

        2:
        begin
            app_rd_en <= 1'b0;
            rd_st <= 3;
        end

        3:
        begin
            app_rd_en <= 1'b0;

            if  ( app_rd_data[ 8 ] & app_rd_data[ 17 ] & app_rd_data[ 26 ] & app_rd_data[ 35 ] )
            begin
                app_rd_en <= 1'b1;
                rd_st <= 2;
            end
            else //data
            begin
                app_data <= app_rd_data[ 35: 0 ];
                rd_st <= 4;
            end

        end

        4:
        begin
            if ( rd_vld )
            begin
                app_rdy <= 1'b1;
                app_rd_en <= 1'b1;
                rd_st <= 5;
            end
        end

        5:
        begin
            app_rdy <= 1'b0;
            app_rd_en <= 1'b0;
            rd_st <= 6;
        end

        6:
        begin
            if ( app_rd_data[ 8 ] & app_rd_data[ 17 ] & app_rd_data[ 26 ] & app_rd_data[ 35 ] )
            begin
                last <= 1'b1;
                pac_minus <= 1;
                rd_st <= 7;
            end
            else
            begin
                app_data <= app_rd_data[ 35: 0 ];
                rd_st <= 4;
            end
        end

        7:
        begin
            pac_minus <= 0;
            last <= 1'b0;
            rd_st <= 0;
        end

        default:
            rd_st <= 0;

    endcase


recv_fifo_rd_wr recv_fifo_rd_wr_inst
(
    .rd_clk         ( rd_clk ),
    .wr_clk         ( wr_clk ),
    .clk_400M       ( clk_400M ),
    .rst            ( rst ),
    .rx             ( rx ),
    .app_rd_en      ( app_rd_en ),
    .app_rd_data    ( app_rd_data ),
    .pac_minus      ( pac_minus ),
    .packets_count  ( packets_count ),
    .fifo_prog_empty( fifo_prog_empty )

);


endmodule
由于例2并不是完整的代码,因此并不能综合和仿真。详细的代码解读可以参看对应的视频。







