在串行高速通信的发送端加入乒乓Buffer缓冲后,经过仿真可以看出,的确有效的缓解了异步过程中数据突发性,随机性与过程调度的冲突。同时也打破了数据链路层与应用层的紧耦合的逻辑,降低了设计的复杂度。在接收端也面临同样的问题,因此也需要加入乒乓Buffer机制有效缓冲调度机制带来的压力。在本高速通信的案例工程中,经研究在接收端,乒乓Buffer仍然插入到应用层与数据链路层之间是最合适的。
1. 乒乓Buffer例化
由于在数据接收端依然使用TDP RAM, 而且两边都是16位接口,因此直接使用发送端生成的TDP RAM进行例化即可,不需要重新生成新的IP。数据链路层的 乒乓Buffer例化如下:
tx_pingpong_buffer rx_pingpong_buffer_inst
(
    //====================================a port, being connected app layer
    .clock_a    ( clk_100M ),
    .address_a  ( rx_addr_a ),
    .rden_a     ( 1'b1 ),
    .wren_a     ( rx_en_a ),
    .data_a     ( 16'b0),
    .q_a        ( rx_q_a ),

    //====================================b port,
    .clock_b    ( clk_100M ),
    .address_b  ( rx_addr_b ),
    .rden_b     ( 1'b1 ),
    .wren_b     ( rx_wren_b ),
    .data_b     ( 16'b0 ),
    .q_b        ( rx_q_b )
);
其中双端口RAM的b端口用于和物理层(Phy)做接口, 而a端口用于与应用层的接口。
2. 数据链路层的程序设计
参照数据缓冲与乒乓Buffer 的交换机制,以及与物理层的握手机制,数据链路层代码如下:
module recv_data_link #
(
    parameter SYNC_START1 = 10'b0011111010,      //K28.5 with dipin=0;
    parameter SYNC_START2 = 10'b1100000101,      //K28.5 with dispin=1

    parameter SYNC_END1 = 10'b0011111001,        //K28.1 with dipin=0;
    parameter SYNC_END2 = 10'b1100000110        //K28.1 with dispin=1
)
(
    input rst,
    input clk_100M ,
    input clk_400M ,
    input rx,
    input [ 10: 0 ] app_rx_addr_a,
    input app_rx_wren_a,
    output[ 15: 0 ] app_rx_q_a
);


wire link_ko;

wire link_rx_data_rdy;
wire [ 7: 0 ] link_rx_data;
wire link_rx_data_vld;


reg [ 9: 0 ] rx_addr_b_r;
reg rx_pinpong;

wire [ 10: 0 ] rx_addr_b = { rx_pinpong, rx_addr_b_r };
wire [ 15: 0 ] rx_q_b;
reg [ 15: 0 ] rx_data_b;
reg [ 10: 0 ] rx_num_b;
reg rx_wren_b;


reg [ 2: 0 ] link_rx_st;


always@( posedge clk_100M or posedge rst )
    if ( rst )
    begin
        rx_addr_b_r <= 1023;
        rx_pinpong <= 0;
        rx_data_b <= 0;
        rx_wren_b <= 0;

        rx_num_b <= 0;

        link_rx_st <= 0;
    end
    else
    case ( link_rx_st )
        0:
        begin
            rx_addr_b_r <= 1023;
            rx_pinpong <= 0;
            rx_data_b <= 0;
            rx_wren_b <= 0;

            rx_num_b <= 0;
            link_rx_st <= 1;
        end
        1:
        begin
            link_rx_st <= 2;
        end
        2:
        begin
            if ( ~rx_q_b[ 15 ] && ~link_rx_data_vld )
                link_rx_st <= 3;
        end
        3:
        begin
            if ( link_rx_data_vld )
                link_rx_st <= 4;
        end
        4:
        begin
            rx_wren_b <= 0;

            if ( !link_rx_data_vld )
            begin
                link_rx_st <= 6;
            end
            else if ( link_rx_data_rdy )
            begin
                rx_num_b <= rx_num_b + 1'b1;
                // rx_addr_b_r     <=rx_addr_b_r+1'b1;
                rx_data_b[ 7: 0 ] <= link_rx_data;
                link_rx_st <= 5;
            end
        end
        5:
        begin
            rx_wren_b <= 0;

            if ( !link_rx_data_vld )
            begin
                rx_addr_b_r <= rx_addr_b_r + 1'b1;
                rx_wren_b <= 1;
                link_rx_st <= 6;
            end
            else if ( link_rx_data_rdy )
            begin
                rx_num_b <= rx_num_b + 1'b1;
                rx_data_b[ 15: 8 ] <= link_rx_data;
                rx_addr_b_r <= rx_addr_b_r + 1'b1;
                rx_wren_b <= 1'b1;
                link_rx_st <= 4;
            end
        end
        6:
        begin
            rx_wren_b <= 1;
            rx_addr_b_r <= 1023;
            rx_data_b <= { 1'b1, 4'b0000, rx_num_b };
            link_rx_st <= 7;
        end
        7:
        begin
            rx_wren_b <= 0;
            rx_pinpong <= rx_pinpong + 1'b1;
            rx_num_b <= 0;
            link_rx_st <= 1;
        end
        default:
            link_rx_st <= 0;
    endcase


tx_pingpong_buffer rx_pingpong_buffer_inst
(
    //====================================a port, being connected app layer
    .clock_a        ( clk_100M ),
    .address_a      ( app_rx_addr_a ),
    .rden_a         ( 1'b1 ),
    .wren_a         ( app_rx_wren_a ),
    .data_a         ( 16'b0 ),
    .q_a            ( app_rx_q_a ),

    //====================================b port,
    .clock_b        ( clk_100M ),
    .address_b      ( rx_addr_b ),
    .rden_b         ( 1'b1 ),
    .wren_b         ( rx_wren_b ),
    .data_b         ( rx_data_b ),
    .q_b            ( rx_q_b )
);


recv_data_pcs #
(
    .SYNC_START1( 10'b0011111010 ),        //K28.5 with dipin=0;
    .SYNC_START2( 10'b1100000101 ),        //K28.5 with dispin=1

    .SYNC_END1  ( 10'b0011111001 ),        //K28.1 with dipin=0;
    .SYNC_END2  ( 10'b1100000110 )         //K28.1 with dispin=1
)
recv_data_pcs_inst
(
    .rst            ( rst ),
    .clk_100M       ( clk_100M ),
    .clk_400M       ( clk_400M ),
    .rx             ( rx ),
    .pcs_rx_data_rdy( link_rx_data_rdy ),
    .pcs_ko         ( link_ko ),
    .pcs_rx_data    ( link_rx_data ),
    .pcs_rx_data_vld( link_rx_data_vld )
);

endmodule
2. 顶层修改后的文件
module hs_txrx
#(
    parameter IDLE = 10'b1010_1010_10
)
(
    input inclk,
    input pll_rst,

    input [ 10: 0 ] tx_addr,
    input [ 15: 0 ] tx_data,
    input tx_en,
    output[ 15: 0 ] tx_q,

    output tx,

    input rx,
    input [10:0]app_rx_addr_a,
    input       app_rx_wren_a,
    output[15:0]app_rx_q_a,

    output clk_100M,
    output pll_locked
);


wire clk_400M;

wire rst = !pll_locked;


trans_data_link
#(
    .IDLE( IDLE )
)
trans_data_link_inst
(
    .rst        ( rst ),
    .clk_100M   ( clk_100M ),
    .tx_addr_a  ( tx_addr ),
    .tx_data_a  ( tx_data ),
    .tx_en_a    ( tx_en ),
    .tx_q_a     ( tx_q ),
    .tx_out     ( tx )
);

recv_data_link #
(
    .SYNC_START1( 10'b0011111010 ),       //K28.5 with dipin=0;
    .SYNC_START2( 10'b1100000101 ),       //K28.5 with dispin=1

    .SYNC_END1  ( 10'b0011111001 ),       //K28.1 with dipin=0;
    .SYNC_END2  ( 10'b1100000110 )        //K28.1 with dispin=1
)
recv_data_link_inst
(
    .rst                ( rst ),
    .clk_100M           ( clk_100M ),
    .clk_400M           ( clk_400M ),
    .rx                 ( rx ),
    .app_rx_addr_a      (app_rx_addr_a),
    .app_rx_wren_a      (app_rx_wren_a),
    .app_rx_q_a         (app_rx_q_a)
);


pll1 pll1_inst
(
    .areset ( pll_rst ),    //1'b0;
    .inclk0 ( inclk ),
    .c0     ( clk_100M ),
    .c1     ( clk_400M ),
    .locked ( pll_locked )
);


endmodule
4.应用层程序
应用层的代码(这里用仿真程序模拟应用层程序)
`timescale 1 ns / 1 ps
module tb_pinpong
       ( );

parameter [ 10: 0 ] LEN = 17;
parameter PERIOD = 20 ;    //周期20
parameter IDLE = 10'b1010_1010_10;

reg inclk ;       // 模拟板级提供的输入时钟

initial
begin
    inclk = 1'b0;
    #( PERIOD / 2 );

    forever
        #( PERIOD / 2 ) inclk = ~inclk;
end


reg pll_rst;     //实体模块PLL的rst信号
wire tx_rx;      // 收发在testbench的回环信号

wire clk_100M;
wire pll_locked;    //实体PLL锁定信号
wire rst = !pll_locked;     //Testbench内生成复位信号

reg [ 9: 0 ] tx_addr_r;
reg tx_pinpong;
wire [ 10: 0 ] tx_addr = { tx_pinpong, tx_addr_r };

reg [ 15: 0 ] tx_data;      //待发送数据
reg [ 7: 0 ] tx_data_r;
reg tx_en;
wire [ 15: 0 ] tx_q;


reg [ 9: 0 ] app_rx_addr_r;
reg app_rx_pingpong;
wire [ 10: 0 ] app_rx_addr_a = { app_rx_pingpong, app_rx_addr_r };

reg app_rx_wren_a;
wire [ 15: 0 ] app_rx_q_a;
reg [ 10: 0 ] rev_len;
reg rx_data_vld;
reg [ 15: 0 ] app_rx_data;


reg [ 7: 0 ] frame_len;

reg [ 2: 0 ] tx_st;


initial
begin
    pll_rst = 1'b1;
    #50 pll_rst = 1'b0;
end

//=====================================schedule for multi_task or multi_procedure ;

reg tx_rdy;   //master schedule and authorise tx precudure become active stream.
reg tx_rdy_ack;

reg rx_rdy;
reg rx_rdy_ack;
reg [ 2: 0 ] sch_st;  //mimic master schedule,

always@( posedge clk_100M or posedge rst )
    if ( rst )
    begin
        tx_rdy <= 0;
        rx_rdy <= 0;
        sch_st <= 0;
    end
    else
    case ( sch_st )
        0:
        begin
            tx_rdy <= 1'b1;

            if ( tx_rdy_ack )
            begin
                tx_rdy <= 1'b0;
                sch_st <= 1;
            end
        end
        1:
        begin
            rx_rdy <= 1'b1;

            if ( rx_rdy_ack )
            begin
                rx_rdy <= 1'b0;
                sch_st <= 2;
            end
        end
        2:
        begin
            sch_st <= 3;
        end
        3:
        begin
            sch_st <= 4;
        end
        4:
        begin
            sch_st <= 5;
        end
        5:
        begin
            sch_st <= 6;
        end
        6:
        begin
            sch_st <= 7;
        end
        7:
        begin
            sch_st <= 0;
        end
        default:
            sch_st <= 0;
    endcase

wire [ 7: 0 ] tx_data_p = tx_data_r + 1;

always@( posedge clk_100M or posedge rst )
    if ( rst )
    begin
        frame_len <= 0;

        tx_addr_r <= 1023;
        tx_pinpong <= 0;

        tx_data <= 0;
        tx_data_r <= 0;
        tx_en <= 1'b0;
        tx_rdy_ack <= 0;

        tx_st <= 0;
    end
    else
    begin
        case ( tx_st )
            0:
            begin
                tx_addr_r <= 1023;
                tx_pinpong <= 0;
                tx_data <= 0;
                tx_rdy_ack <= 0;
                frame_len <= 0;
                tx_st <= 1;
            end
            1:
            begin
                tx_rdy_ack <= 0;

                if ( tx_rdy )
                    tx_st <= 2;
            end
            2:
            begin
                if ( tx_q[ 15 ] )
                    tx_st <= 6;
                else
                    tx_st <= 3;
            end
            3:
            begin
                if ( frame_len >= LEN )
                begin
                    tx_en <= 1'b0;
                    tx_st <= 4;
                end
                else
                begin
                    tx_data <= { tx_data_p, tx_data_r };
                    frame_len <= frame_len + 2;
                    tx_addr_r <= tx_addr_r + 1;
                    tx_data_r <= tx_data_r + 2;
                    tx_en <= 1'b1;
                end
            end
            4:
            begin
                tx_data <= { 1'b1, 4'b0, LEN };
                frame_len <= 0;
                tx_addr_r <= 1023;
                tx_en <= 1'b1;
                tx_st <= 5;
            end
            5:
            begin
                tx_en <= 1'b0;
                tx_pinpong <= tx_pinpong + 1'b1;

                tx_st <= 6;
            end
            6:
            begin
                tx_rdy_ack <= 1'b1;
                tx_st <= 7;
            end
            7:
            begin
                tx_rdy_ack <= 1'b0;
                tx_st <= 1;
            end
            default:
                tx_st <= 0;
        endcase
    end


reg [ 2: 0 ] rx_st;
reg [ 10: 0 ] rx_length;
always@( posedge clk_100M or posedge rst )
    if ( rst )
    begin
        rx_rdy_ack <= 1'b0;
        app_rx_addr_r <= 1023;
        app_rx_pingpong <= 0;
        app_rx_wren_a <= 0;
        rev_len <= 0;
        rx_length <= 0;
        rx_data_vld <= 0;
        app_rx_data <= 0;
        rx_st <= 0;
    end
    else
    case ( rx_st )
        0:
        begin
            rx_rdy_ack <= 1'b0;
            app_rx_addr_r <= 1023;
            app_rx_wren_a <= 0;
            rev_len <= 0;
            rx_length <= 0;
            rx_data_vld <= 0;
            app_rx_data <= 0;

            if ( rx_rdy )
                rx_st <= 1;
        end
        1:
        begin
            rx_st <= 2;
        end
        2:
        begin
            if ( app_rx_q_a[ 15 ] )
            begin
                app_rx_addr_r <= 0;
                rx_st <= 3;
            end
            else
            begin
                rx_st <= 7;
                rx_rdy_ack <= 1'b1;
            end
        end
        3:
        begin
            rev_len <= app_rx_q_a[ 10: 0 ];
            rx_length <= app_rx_q_a[ 10: 0 ];
            app_rx_addr_r <= app_rx_addr_r + 1;
            rx_st <= 4;
        end
        4:
        begin
            rx_data_vld <= 1'b0;
            app_rx_data <= app_rx_q_a;

            if ( rev_len <= 1 )
            begin
                rx_st <= 5;
                rx_data_vld <= rev_len[ 0 ];
            end
            else
            begin
                rev_len <= rev_len - 2;
                app_rx_addr_r <= app_rx_addr_r + 1;
                rx_data_vld <= 1'b1;
            end
        end
        5:
        begin
            app_rx_addr_r <= 1023;
            app_rx_wren_a <= 1'b1;
            rx_data_vld <= 1'b0;               //modified after simulation
            rx_st <= 6;
        end
        6:
        begin
            app_rx_pingpong <= app_rx_pingpong + 1;
            app_rx_wren_a <= 1'b0;
            rx_st <= 7;
            rx_rdy_ack <= 1'b1;
        end
        7:
        begin
            rx_rdy_ack <= 1'b0;
            app_rx_wren_a <= 1'b0;
            rx_st <= 0;
        end
        default:
            rx_st <= 0;
    endcase


hs_txrx     #( .IDLE( IDLE ) )
hs_txrx_inst
(
    .inclk          ( inclk ),
    .pll_rst        ( pll_rst ),
    .tx_addr        ( tx_addr ),
    .tx_data        ( tx_data ),
    .tx_en          ( tx_en ),
    .tx_q           ( tx_q ),
    .tx             ( tx_rx ),


    .rx             ( tx_rx ),
    .app_rx_addr_a  ( app_rx_addr_a ),
    .app_rx_wren_a  ( app_rx_wren_a ),
    .app_rx_q_a     ( app_rx_q_a ),
    .clk_100M       ( clk_100M ),
    .pll_locked     ( pll_locked )
);
endmodule
新的应用程序只展示了应用层读数据的过程,并在该程序中加了新的调度。
5.仿真波形:
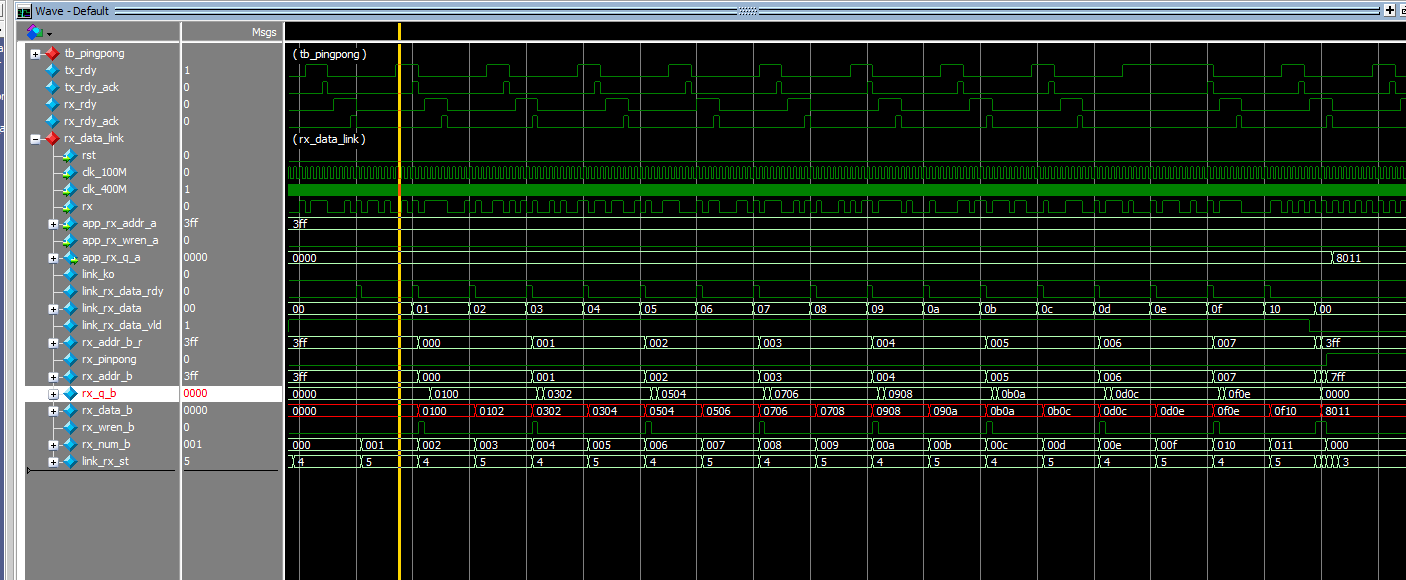
图1-1 数据链路层仿真波形1
观察双口RAM b端口的控制字的值,数据链路层与物理层的握手。
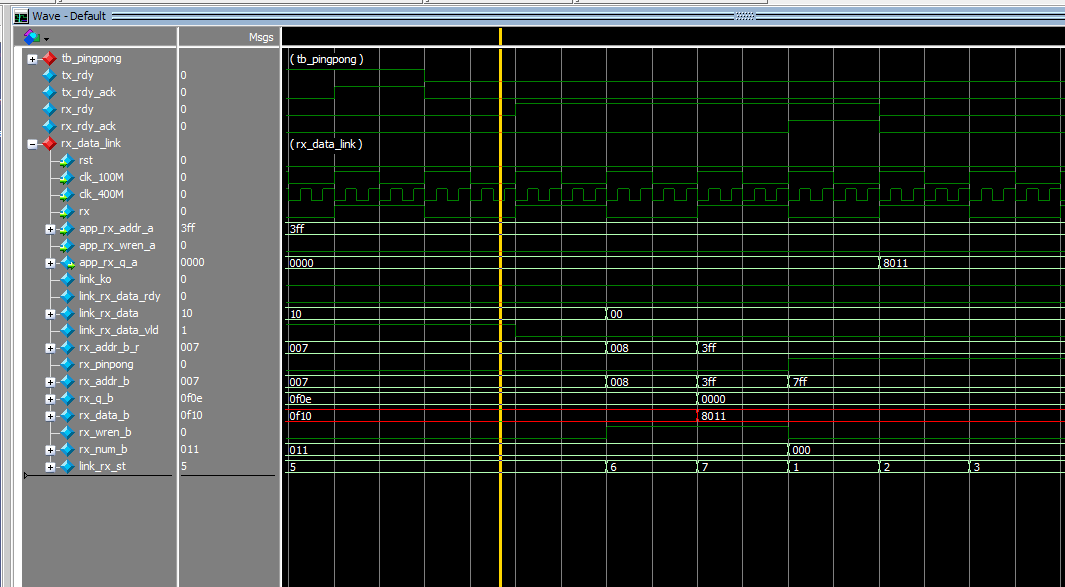
图1-2 数据链路层仿真波形2
图1-2中注意观察写关键字的情况以及乒乓Buffer的交换。
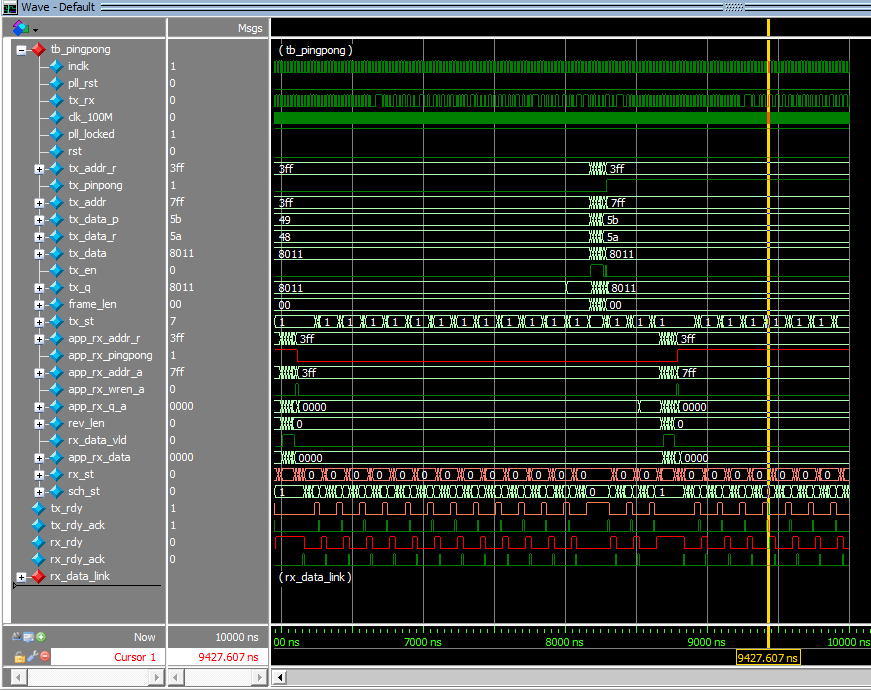
图2-1 观察调度的时间分配
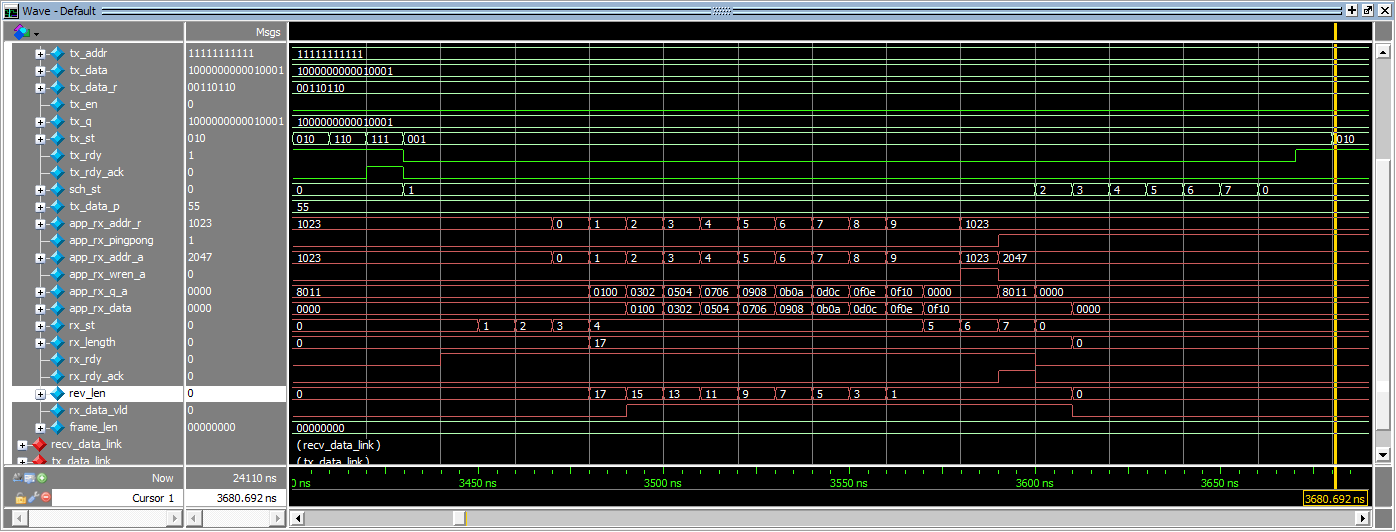
图2-2 观察接收端数据的读取
程序的细节解释请观看对应的视频。








请问这个recv_data_link 层 状态机 link_rx_st 状态0-1-2 ,为什么要延时一拍,是为了后面能直接回到1?
在 recv_data_link 这个程序中,那个 rx_wren_b 这个不是很明白。之前讲的内容中,这个端口是写使能端口,拉高后才能写数据进去,文章中怎么用就搞糊涂了,在视频上讲的也不是很明白。
看了后面的仿真以后都明白了,谢谢。