在上篇文章中,我们讨论并实现了加性/加扰的算法,原理,以及实现方式。在文章中,揭示了算法的实现,设计了利用加扰,解扰演示实例,但是这个演示实例不是非常完善通信工程(目的是演示加扰,解扰的算法)。对于接收端的通讯实现,需要发送端的同步信号,这种方法对于真实的通讯来说,是很难实现的(发送端和接收端都是异步通讯的)。本文中将修改之前的工程,增加preamble + SFD , 实现工程收发同步。 这样,在接收端就可以利用preamble + SFD 所提供的同步信息, 提取出同步字,实现解扰的算法。
仿真工程代码:
`timescale 1 ns / 1 ps
module tb
       (
       );

parameter SYNC1 = 8'b1010_1010;
parameter SYNC2 = 8'b1010_1011;

parameter PERIOD = 20 ;    //周期20
reg pll_rst;     //实体模块PLL的rst信号
wire tx_rx;      // 收发在testbench的回环信号

wire clk_100M;
wire pll_locked;    //实体PLL锁定信号
wire rst = !pll_locked;     //Testbench内生成复位信号

reg [ 7: 0 ] tx_data;      //待发送数据

wire rx_vld;
wire rx_rdy;
wire [ 7: 0 ] rx_data;
reg inclk ;       // 模拟板级提供的输入时钟

reg [ 2: 0 ] tx_st;

initial
begin
    inclk = 1'b0;
    #( PERIOD / 2 );

    forever
        #( PERIOD / 2 ) inclk = ~inclk;
end

//always #10 inclk=~inclk;

initial
begin
    pll_rst = 1'b1;
    tx_data = 0;
    #50 pll_rst = 1'b0;
end

wire tx_rdy;
reg  tx_vld = 0;
reg  tx_en = 0;

reg [5:0] send_cnt = 0;
always@( posedge clk_100M or posedge rst )

    if ( rst )
    begin
        tx_en <= 0;
        tx_st <= 0;
        tx_data <= 0;
    end
    else
    begin
        case ( tx_st )
            0:
            begin
                tx_en <= 0;
                send_cnt <= 0;
                tx_data <= 0;
                tx_vld <= 0;
                tx_st <= 1;
            end
            1:
            begin
                tx_vld <= 1;
                tx_st <= 2;
            end
            2:
            begin
                if(tx_rdy)
                begin
                    tx_data <= 0;
                    tx_en <= 1;
                    send_cnt <= send_cnt + 1;

//                    if(send_cnt == 7)
                        tx_st <= 3;
                end
            end
            3:
            begin
                tx_en <= 0;
                if(tx_rdy)
                begin
                    tx_en <= 1;
                    tx_data <= tx_data + 1;
                    send_cnt <= send_cnt + 1;

//                    if ( send_cnt == 23 )
                    if ( send_cnt == 31 )
                    begin
                        send_cnt <= 0;
                        tx_st <= 7;
                    end
                end
            end
            6:
            begin
                if(tx_rdy)
                begin
                    tx_data <= 8'hff;
                    send_cnt <= send_cnt + 1;

                    if(send_cnt == 31)
                    begin
                        send_cnt <= 0;
                        tx_st <= 7;
                    end
                end
            end
            7:
            begin
                tx_en <= 0;
                tx_vld <= 0;
                send_cnt <= send_cnt + 1;

                if(&send_cnt)
                begin
                    tx_st <= 0;
                end
            end

            default:
                tx_st <= 0;

        endcase
    end


hs_txrx hs_txrx_inst
(
    .inclk      ( inclk ),
    .pll_rst    ( pll_rst ),

    .tx_data    ( tx_data ),
    .tx_en      ( tx_en ),
    .tx_rdy     ( tx_rdy ),
    .tx_vld     ( tx_vld ),

    .tx         ( tx_rx ),
    .rx         ( tx_rx ),

    .rx_vld     ( rx_vld ),
    .rx_rdy     ( rx_rdy ),
    .rx_data    ( rx_data ),

    .clk_100M   ( clk_100M ),
    .pll_locked ( pll_locked )

);

endmodule
顶层文件:
module hs_txrx
#(
    parameter SCRAMB_SYNC = 15'b000_0000_1010_1001,
    parameter SYNC1 = 8'b1010_1010,
    parameter SYNC2 = 8'b1010_1011
)
(
    input inclk,
    input pll_rst,


    input [ 7: 0 ] tx_data,
    input  tx_en,
    output tx_rdy,
    input  tx_vld,

    output tx,
    input rx,


    output rx_rdy,
    output rx_vld,
    output [ 7: 0 ] rx_data,

    output clk_100M,
    output pll_locked
);


wire clk_400M;

wire rst = !pll_locked;


trans_data
#(
    .SCRAMB_SYNC(SCRAMB_SYNC),
    .SYNC1( SYNC1 ),
    .SYNC2( SYNC2 )
)
trans_data_inst
(
    .rst        ( rst ),
    .clk_100M   ( clk_100M ),
    .tx_data    ( tx_data ),    // 100M的时钟对应的数据
    .tx_en      ( tx_en ),
    .tx_vld     ( tx_vld ),
    .tx_rdy     ( tx_rdy ),
    .tx_out     ( tx )
);


rev_pcs
#(
    .SCRAMB_SYNC( SCRAMB_SYNC ),
    .SYNC1( SYNC1 ),
    .SYNC2( SYNC2 )
)
recv_pcs_inst
(
    .rst        ( rst ),
    .clk_100M   ( clk_100M ),
    .clk_400M   ( clk_400M ),

    .rx_vld     ( rx_vld ),
    .rx_data    ( rx_data ),
    .rx_rdy     ( rx_rdy ),

    .rx         ( rx )
);


pll1 pll1_inst
(
    .areset ( pll_rst ),    //1'b0;
    .inclk0 ( inclk ),
    .c0     ( clk_10M ),
    .c1     ( clk_100M ),
    .c2     ( clk_400M ),
    .locked ( pll_locked )
);


endmodule
trans_data.v文件:
module trans_data
#(
    parameter SCRAMB_SYNC = 15'b000_0000_1010_1001,
    parameter SYNC1 = 8'b1010_1010,
    parameter SYNC2 = 8'b1010_1011
)
(
    input  rst,
    input  clk_100M,

    output reg tx_rdy = 0,

    input  tx_vld,
    input  tx_en,

    input  [ 7: 0 ] tx_data,    // 100M的时钟对应的数据
    output tx_out
);


reg [ 14: 0 ] scrambler;
reg scb_en = 0;
reg [7:0] scb_bit_vector = 0;

integer i;
always@( posedge clk_100M )
if ( ~tx_vld )
begin
    scb_bit_vector = 0;
    scrambler = SCRAMB_SYNC;
end
else if(scb_en)
begin
    for (i = 0; i < 8; i = i + 1) begin
        scb_bit_vector[ i ] = scrambler[ 14 ] ^ scrambler[ 13 ];
        scrambler = {scrambler[13:0], scb_bit_vector[ i ]};
    end
end

reg [7:0] tx_pma_in = 0;
reg tx_pma_en = 0;
wire tx_pma_req;
reg [ 2: 0 ] scb_st;
always@( posedge clk_100M or posedge rst )
if ( rst )
begin
    scb_st <= 0;
    tx_rdy <= 0;
end
else
begin
    case ( scb_st )
        0:
        begin
            tx_pma_en <= 0;
            tx_rdy <= 1'b0;
            tx_pma_in <= SYNC1;

            if ( tx_vld)
            begin
                scb_st <= 1;
            end
        end
        1:
        begin
            tx_pma_en <= 0;
            if(tx_pma_req)
            begin
                tx_pma_en <= 1;
                tx_pma_in <= SYNC1;
                scb_st <= 2;
            end
        end
        2:
        begin
            tx_rdy <= 0;

            tx_pma_en <= 0;
            if(tx_pma_req)
            begin
                tx_pma_en <= 1;
                tx_pma_in <= SYNC2;
                tx_rdy <= 1;
                scb_en <= 1;
                scb_st <= 3;
            end
        end
        3:
        begin
            tx_rdy <= 0;
            scb_en <= 0;
            tx_pma_en <= 0;

            if ( tx_pma_req )
            begin
                tx_pma_en <= 1;
                tx_pma_in <= tx_data ^ scb_bit_vector;
                scb_en <= 1;

                if ( ~tx_vld ) scb_st <= 4;
                else tx_rdy <= 1;
            end
        end
        4:
        begin
            scb_en <= 0;
            tx_rdy <= 0;

            tx_pma_en <= 0;
            if(tx_pma_req)
            begin
                tx_pma_en <= 1;
                tx_pma_in <= SYNC1;
                scb_st <= 0;
            end
        end
        default:
            scb_st <= 0;

    endcase
end


trans_pma
#(
    .SCRAMB_SYNC(SCRAMB_SYNC),
    .SYNC1      (SYNC1),
    .SYNC2      (SYNC2)
)
trans_pma_inst
(
    .clk_100M   ( clk_100M ),

    .tx_pma_en  ( tx_pma_en ),
    .tx_pma_req ( tx_pma_req ),
    .tx_pma_in  ( tx_pma_in ),

    .tx_out     ( tx_out ),

    .rst        ( rst)
);


endmodule
trans_pma.v
module trans_pma
#(
    parameter SCRAMB_SYNC = 15'b000_0000_1010_1001,
    parameter SYNC1 = 8'b1010_1010,
    parameter SYNC2 = 8'b1010_1011
)
(
    input clk_100M,

    input  tx_pma_en,
    output reg tx_pma_req = 0,
    input [ 7: 0 ] tx_pma_in,    // 100M的时钟对应的数据

    output tx_out,

    input rst
);


reg [7:0] tx_data_temp;
always@( posedge clk_100M or posedge rst )
if(rst)
    tx_data_temp <= 8'b1010_1010;
else if ( tx_pma_en )
    tx_data_temp <= tx_pma_in;


reg [7:0] tx_shift;
reg [2:0] tx_cnt = 0;
wire tx_pma_reload = (tx_cnt == 7) ? 1'b1 : 1'b0;

always@( posedge clk_100M or posedge rst )
if(rst)
begin
    tx_pma_req <= 0;
    tx_shift <= 8'b1010_1010;
    tx_cnt <= 0;
end
else
begin
    tx_pma_req <= 0;

    if ( tx_pma_reload )
    begin
        tx_pma_req <= 1;
        tx_shift <= tx_data_temp;
    end
    else
        tx_shift <= {tx_shift[ 0 ], tx_shift[ 7: 1 ]};

    tx_cnt <= tx_cnt + 1;
end


// pmd
IO_TX IO_TX_inst
(
    .tx_in  ( tx_shift[0] ),
    .tx_out ( tx_out )
);


endmodule
rec_pcs.v
module rev_pcs
#(
    parameter SCRAMB_SYNC = 15'b000_0000_1010_1001,
    parameter SYNC1 = 8'b1010_1010,
    parameter SYNC2 = 8'b1010_1011
)
(
    input rx,

    output reg rx_vld = 0,
    output rx_rdy,
    output reg [ 7: 0 ] rx_data,

    input  clk_100M,
    input  clk_400M,
    input  rst
);


wire sync;
wire [7:0] rx_data_scb ;
reg [ 14: 0 ] scrambler;
wire scb_en;
reg [7:0] scb_bit_vector = 0;
integer i;
always@( posedge clk_100M )
if ( ~sync )
begin
    scb_bit_vector = 0;
    scrambler = SCRAMB_SYNC;
end
else if(scb_en)
begin
    for (i = 0; i < 8; i = i + 1) begin
        scb_bit_vector[ i ] = scrambler[ 14 ] ^ scrambler[ 13 ];
        scrambler = {scrambler[13:0], scb_bit_vector[ i ]};
    end
end

recv_data
#(
    .SYNC1( SYNC1 ),
    .SYNC2( SYNC2 )
)
recv_data_inst
(
    .rst              ( rst ),
    .clk_100M         ( clk_100M ),
    .clk_400M         ( clk_400M ),
    .sync             ( sync ),
    .rx               ( rx ),
    .rx_data_100Mr    ( rx_data_scb ),
    .rx_data_vld_100Mr( scb_en )
);

reg [1:0] rx_vld_r = 0;
always @ (posedge clk_100M)
begin
    rx_vld_r <= {rx_vld_r[0], scb_en};
end

always @ (posedge clk_100M)
if(rx_vld_r[0])
begin
    rx_data = rx_data_scb ^ scb_bit_vector;
end

always @ (posedge clk_100M)
if(sync) rx_vld <= 1;
else  if(rx_rdy) rx_vld <= 0;


assign rx_rdy = rx_vld_r[1];


endmodule
recv_data.v
module recv_data
#(
    parameter SYNC1 = 8'b1010_1010,
    parameter SYNC2 = 8'b1010_1011
)
(
    input rst,
    input clk_100M,
    input clk_400M,
    input rx,
    output reg sync = 0,
    output reg[ 7: 0 ] rx_data_100Mr,
    output reg rx_data_vld_100Mr
);


wire rx_bit;
wire rx_bit_vld;

reg [ 3: 0 ] bit_count;
reg [ 7: 0 ] bit_sft;
reg [ 7: 0 ] sync_shift = 0;

reg fr_sync1, fr_sync2;
reg fr_sync;

always @ (posedge clk_100M)
sync <= fr_sync;

reg fr_end;
reg [ 7: 0 ] fr_count;

reg[ 7: 0 ] rx_data;
reg rx_data_vld_tmp;

always@( posedge clk_400M or posedge rst )

    if ( rst )
    begin
        rx_data <= 0;
        rx_data_vld_tmp <= 0;
        bit_count <= 0;
        bit_sft <= 0;
        fr_sync1 <= 0;
        fr_sync2 <= 0;
        fr_sync <= 0;
        fr_end <= 0;
        fr_count <= 0;
    end
    else
    begin
        if ( rx_bit_vld )
        begin
            bit_sft <= { rx_bit, bit_sft[ 7: 1 ]};
            sync_shift <= { bit_sft[ 0 ], sync_shift[ 7: 1] };
        end

        if ( fr_sync )
            fr_sync2 <= 1'b0;
        else if ( bit_sft == SYNC2 )
            fr_sync2 <= 1'b1;         //fr----frame
        else
            fr_sync2 <= 1'b0;

        if ( fr_sync )
            fr_sync1 <= 1'b0;
        else if ( sync_shift == SYNC1 )
            fr_sync1 <= 1'b1;
        else
            fr_sync1 <= 1'b0;

        if ( fr_end )
            fr_sync <= 1'b0;
        else if ( fr_sync1 & fr_sync2 & rx_bit_vld )
            fr_sync <= 1'b1;

        if ( fr_sync )
        begin
            if ( rx_bit_vld )
            begin
                if ( bit_count == 7 )
                    bit_count <= 0;
                else
                    bit_count <= bit_count + 1;
            end
        end

        rx_data_vld_tmp <= 0;

        if ( bit_count == 7 )
        begin
            rx_data <= bit_sft;
            rx_data_vld_tmp <= 1'b1;
        end

        fr_end <= 1'b0;

        if ( rx_data_vld_tmp & rx_bit_vld )
            if ( fr_count == 31 )
            begin
                fr_end <= 1'b1;
                fr_count <= 0;
            end
            else
                fr_count <= fr_count + 1;
    end


wire rx_data_vld = rx_data_vld_tmp & rx_bit_vld;

reg rx_data_vld_r;
reg [ 5: 0 ] count_400M;
reg rx_data_vld_x;
reg nrx_data_vld_x;
reg rx_data_vld_xrg;

always@( posedge clk_400M or posedge rst )

    if ( rst )
    begin
        count_400M <= 0;
        rx_data_vld_r <= 0;
    end
    else
    begin
        if ( rx_data_vld )
            rx_data_vld_r <= 1'b1;
        else if ( count_400M == 15 )
            rx_data_vld_r <= 1'b0;

        if ( count_400M == 15 )
            count_400M <= 0;
        else if ( rx_data_vld_r )
            count_400M <= count_400M + 1;
    end

always@( posedge clk_100M or posedge rst )

    if ( rst )
    begin
        rx_data_vld_x <= 1'b0;
        nrx_data_vld_x <= 1'b1;

        rx_data_vld_xrg <= 1'b0;

        rx_data_100Mr <= 0;

        rx_data_vld_100Mr <= 1'b0;
//        rx_data_vld_100Mrr <= 1'b0;

    end
    else
    begin
        rx_data_vld_x <= rx_data_vld_r;
        nrx_data_vld_x <= !rx_data_vld_x;
        rx_data_vld_xrg <= nrx_data_vld_x & rx_data_vld_x;

        rx_data_vld_100Mr <= 1'b0;

        if ( rx_data_vld_xrg )
        begin
            rx_data_100Mr <= rx_data;
            rx_data_vld_100Mr <= 1'b1;
        end
    end


recv_bit recv_bit_inst
(
    .rst        ( rst ),
    .clk_400M   ( clk_400M ),
    .rx         ( rx ),
    .rx_bit     ( rx_bit ),
    .rx_bit_vld ( rx_bit_vld )

);


endmodule
仿真结果:
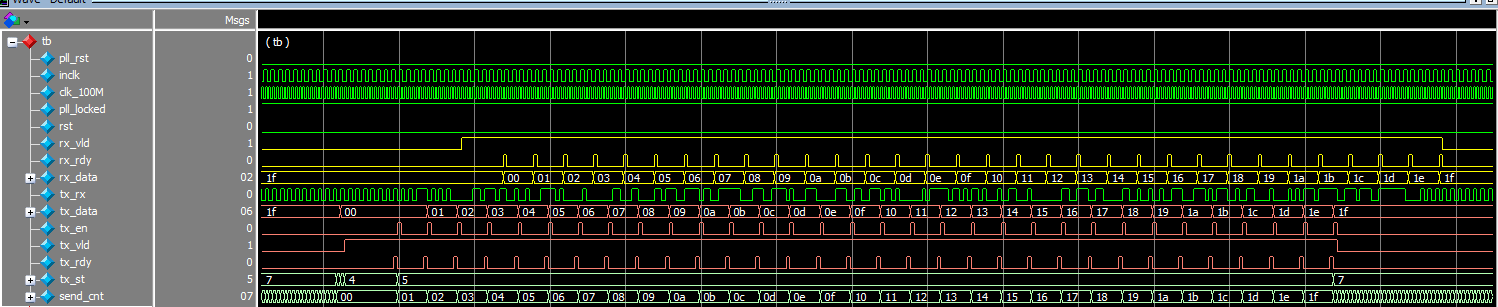
图1
仿真程序中发送数据 8’h00, 8’h01, 8’h02, ….. 8’h1f , 接收端可以正常接收到8’h00, 8’h01, 8’h02, …. 8’h1f。
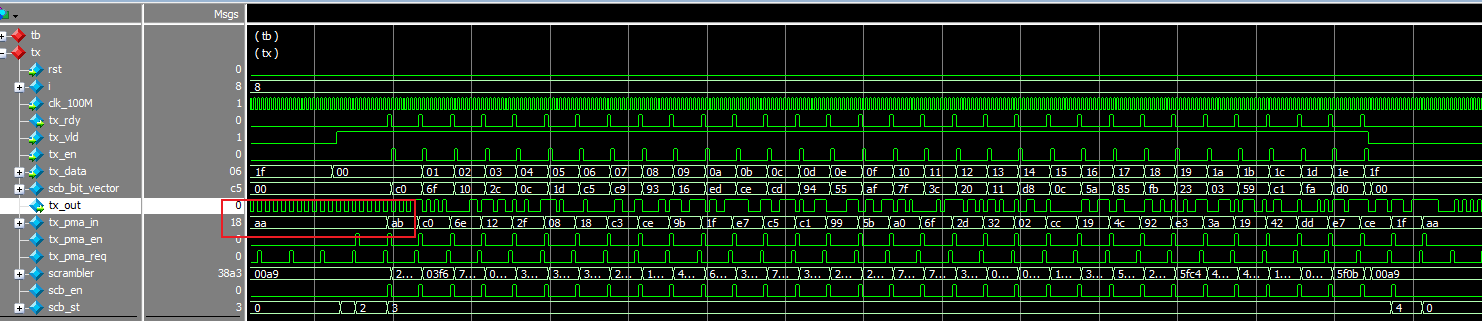
图2
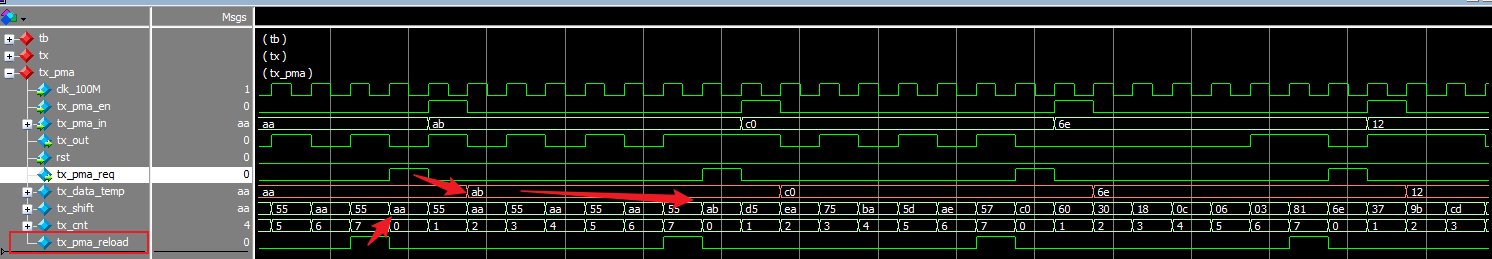
图3
tx_pma_reload 将tx_data_temp (之前锁存的数据)装载到tx_shift 中, 同时发送tx_pma_req 请求下一个数据,只要下一个数据在reload之前准备好就可以了, 这样就给上层程序预留了很多时间(有一定的弹性)。
quartus 代码
[contend_control]
[/contend_control]
关于程序的更多讲解, 请参照视频文件。








老师,里面有个for循环,for i=0,i<8 , i = i + 1;为什么一个clk沿,i可以从0到7,不是应该每个clk只加1吗?