文章 Xilinx专用设计代码风格中提到从FPGA器件特征角度出发,尽可能的多使用已经存在的芯片结构,来优化资源的利用。本文将介绍Xilinx 7系列FPGA中原语 SRL16E的结构背景和使用。SRL16E原语调用的是移位寄存器,而移位寄存器位于FPGA中的配置逻辑块(CLB,Configurable Logic Block),本文将先简单介绍CLB。
1. 7系列FPGA中配置逻辑块(CLB)简介
CLB(Configurable Logic Block)是7系列FPGA的基本内部结构。一般来说,设计工程师不需要考虑 CLB 资源的逻辑分配,因为智能的综合器会自动实现。 但是了解CLB的特点可以帮助工程师在设计RTL时更有效的使用FPGA器件资源,包括CLB中查找表(LUT,Look-up table)的不同功能、进位(carry)传递的物理方向、可用触发器(flip-flop)的数量,分布和触发器的可用性,高效的移位寄存器等。由于CLB相关的特点过于复杂,本文将专注于介绍CLB中移位寄存器的特点。
一个CLB块包括两个SLICE。7系列FPGA中有两种SLICE,分别为SLICEL和SLICEM。SLICEL大约是SLICEM数量的两倍左右,以FII-PRX100-D所使用的7A100T芯片为例,其中SLICEM有4750个,SLICEL有11100个。所以CLB有两种SLICE组合:SLICEL + SLICEL,SLICEL + SLICEM。相较于SLICEL,SLICEM中的LUT可以用于distributed 64-bit RAM或是32-bit 移位寄存器(一个SRL32可以分为两个SRL16),注意移位寄存器不需要使用SLICEM中的触发器。在Vivado工程综合后,选中SYSTHESIS,点击菜单Window -> Device,即可以观察到如图1,图2所示的界面,找到FPGA主体CLB区。

图1 打开Device

图2 CLB
SLICEM和SLICEL的位置示意如图3所示,左边的SLICE是SLICEM,右边的SLICE是SLICEL。可以看出两个SLICE的组成基本一致:8个D触发器,一些逻辑门,MUX和四个LUT6。但是注意从图3中也可以看出,SLICEM中的LUT6的接口更多,SLICEL中LUT6的接口比较少。
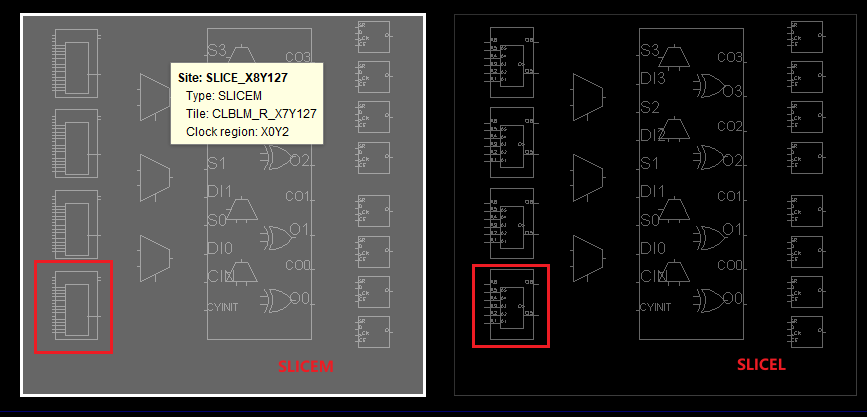
图3 SLICEM和SLICEL
2. SRL16E原语用法
本文主要介绍移位寄存器中SRL16E原语的用法,7系列FPGA中移位寄存器的原语只有SRL16E和SRLC32E两种。在学会SRL16E原语的用法后,很容易触类旁通理解SRLC32E原语的用法。
SRL16E原语的端口示意图如图4所示:

图4 SRL16E原语示意图
相关的端口解释如表1所示。
表1:
| 端口 | 输入/输出 | 位宽 | 描述 |
| CE | 输入 | 1 | 高电平有效时钟使能 |
| CLK | 输入 | 1 | 移位寄存器的时钟 |
| D | 输入 | 1 | 数据输入 |
| Q | 输出 | 1 | 数据输出 |
| A0 | 输入 | 1 | A0-A3的值确定移位寄存器的深度,深度=8*A3 + 4*A2 + 2*A1 + A0 + 1,例A3-A0为4’b1100,移位寄存器的深度为13 |
| A1 | 输入 | 1 | |
| A2 | 输入 | 1 | |
| A3 | 输入 | 1 |
表1中的端口具体含义需要结合图5理解SRL16E的原理。为了简化理解,这里将CE上拉,也就是说时钟永远是有效的。可以看出,A3-A0是选择输出Q的位置,图5中所示A3-A0是4’b1001,那么移位寄存器的值从D端输入,到Q端输出会需要延迟10个时钟周期,如图7所示(如果A3-A0 是4’b0000,那么需要1个时钟周期的D端到Q端延时)。移位寄存器的特点是最后输出的Q端会反馈给第一个触发器的D端,如图6所示。注意,在使用SRL16E原语时,移位寄存器中的初始值为INIT,16-bit宽,如果没有明确指出,默认为0。INIT值会作为初始值装载在对应移位寄存器的D端口,举例说明如果INIT值为16’b1100_0110_1001_0001,因为只选择到了第10个移位寄存器,所以参与移位的值只有10’b10_1001_0001,之后D端的值只随着移位寄存器的时钟节拍不断移位。
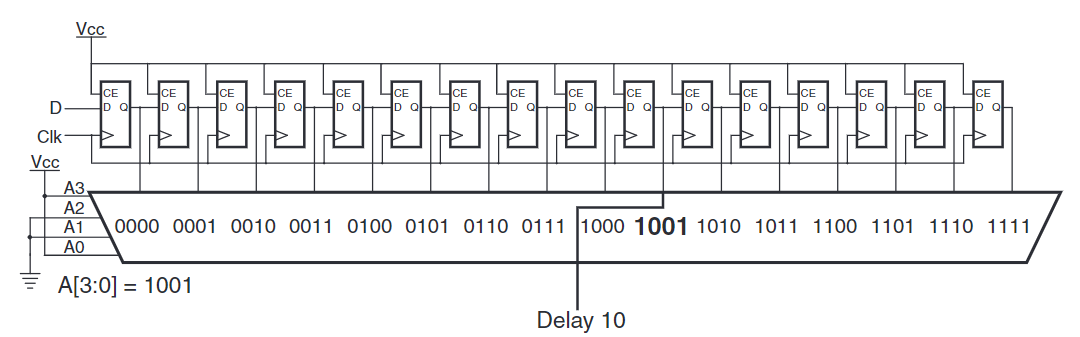
图5 SRL16E原理示意图
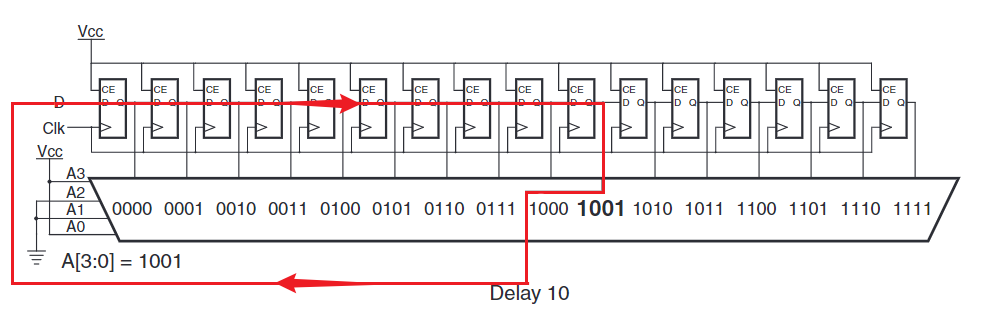
图6 SRL16E内部移位寄存器连接示意图
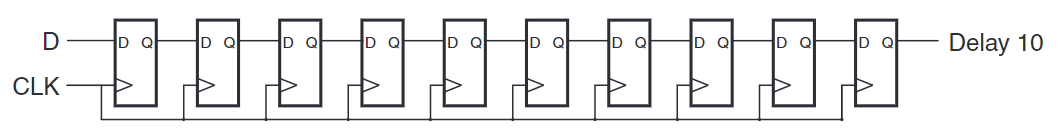
图7 当A3-A0为4’b1001
SRL16E原语的例化如下所示:
// SRL16E: 16-bit shift register LUT with clock enable operating
// on posedge of clock (Mapped to a SliceM LUT6)
// 7 Series

SRL16E #(
    .INIT(16'h2300) // Initial Value of Shift Register
) SRL16E_inst (
    .Q(Q),       // SRL data output
    .A0(A0),     // Select[0] input
    .A1(A1),     // Select[1] input
    .A2(A2),     // Select[2] input
    .A3(A3),     // Select[3] input
    .CE(CE),     // Clock enable input
    .CLK(CLK),   // Clock input
    .D(D)        // SRL data input
);
// End of SRL16E_inst instantiation
3. 使用SRL16E原语实例
例:使用SRL16E原语做一个8分频器。
实现代码如下:
`timescale 1ns / 1ps
module  top #
(
    parameter [31:0] N = 8
)
(
    input  clk,
    output clk_out
);

localparam DIV_COE =  { {(N/2){1'b0}}, {(N/2){1'b1}} };
wire [3:0] a = N - 1;
SRL16E #(
    .INIT(DIV_COE) 			// Initial Value of Shift Register
) SRL16E_inst (
    .Q(clk_out),       		// SRL data output
    .A0(a[0]),
    .A1(a[1]),
    .A2(a[2]),
    .A3(a[3]),
    .CE(1'b1),     			// Clock enable input
    .CLK(clk),   			// Clock input
    .D(clk_out)        		// SRL data input
);

endmodule
其中clk是原时钟,clk_out是经过8分频后的时钟。
仿真工程比较简单,只需要提供实体程序一个时钟即可,如下所示:
`timescale 1ns / 1ps


module tb(

    );
    reg clk = 0;
    wire flag;

    always #5 clk = ~clk;


    top top_inst(
    .clk(clk),
    .clk_out(flag)
    );

endmodule
仿真波形如下所示:

图8 8分频仿真波形
在实体文件中,对于分频系数采用了参数化的设计,但是注意:如果只使用一个SRL16E原语,最大可实现的分频是16分频,并且只能实现偶数分频。如果需要奇数分频,参见文章verilog 奇数,偶数分频逻辑。如果只需要做偶数分频的话,可以对比简单的时钟使能分频(使用多个触发器),使用移位寄存器分频(SRL16E)的好处是不需要使用触发器,资源使用极少,如图9所示,如上文提到SLICEM中的移位寄存器不需要使用额外的触发器。

图9 SRL16E资源使用
为了进行直观的对比,使用时钟使能分频的实例如下所示:
`timescale 1ns / 1ps


module top(
    input clk,
    output reg clk_out= 0
    );


    reg[1:0] div_8 = 0;

    always @ (posedge clk)
    begin
        if(&div_8)
            div_8 <= 0;
        div_8 <= div_8 + 1;
    end


    always @ (*)
        if(div_8 == 3)
            clk_out = ~clk_out;
        else
            clk_out = clk_out;
endmodule
综合后使用的FPGA资源如下图所示:
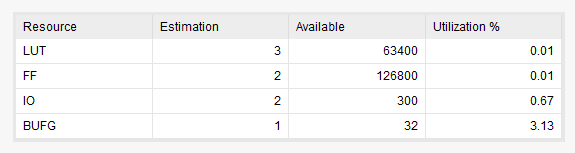
图10(1) 时钟使能分频资源使用
注意8分频理论上需要3个触发器,之所以图10中只显示出了2个触发器,是因为代码综合后生成了一个latch + 2个触发器。latch使用了一个触发器的资源,只不过在综合的时候,没有报告出来,在布线中,可以看到,如下图所示:
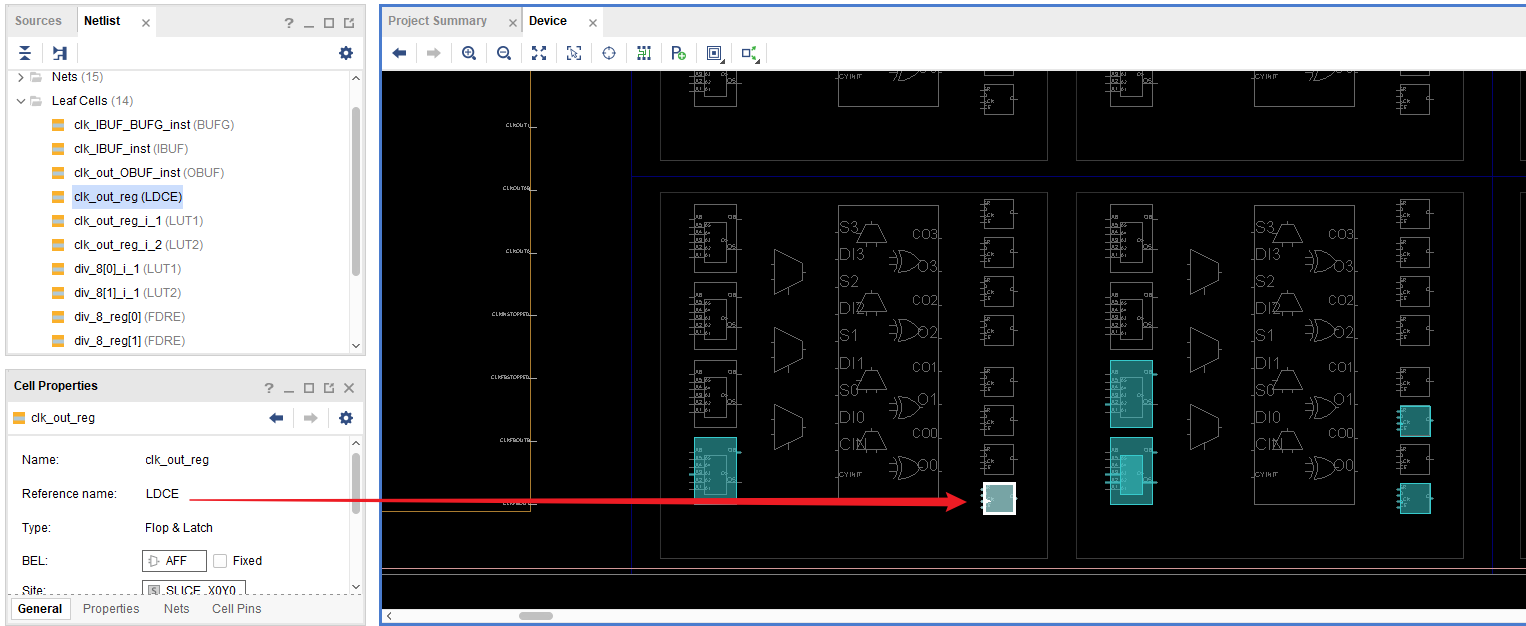
图10(2) 布线后资源情况
如果需要实现16分频,那么使用时钟使能分频使用的资源会更多,如下图所示:
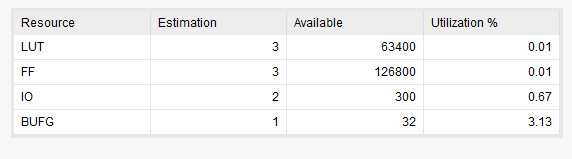
图11 16分频时钟使能分频资源使用
然而,由于16分频仍然可以由一个SRL16E原语实现,所以使用移位寄存器的资源没有改变,如下图所示:
图12 16分频SRL16E资源使用
由此可见,SRL16E在时钟分频上优化利用FPGA资源,在资源紧张的情况下,应当作为首选实现方法。
4. 扩展讨论
EDA工具会自动将简单的延迟转换为 SRL16E 原语。但是除此之外,设计工程师应该将不直接使用延迟的工程,巧妙的利用SRL16E实现。下面列举了一些移位寄存器的应用:
- 作为随机数生成器, 如LFSR(Linear Feedback Shift Register,线性反馈移位寄存器), Pseudo-Random Noise Generator等
- 线性帧同步器(Serial Frame Synchronizer),将一整个帧存储在移位寄存器中,并对帧内每一位数据测试起始位和结束位Pattern
- 使用累加器代替加法树(Adder Tree)实现运行平均值(running average)。运行平均值是一个简单的具有平滑或低通响应FIR滤波器
- 脉冲产生器和时钟分频器,由于实现的移位寄存器都在一个SLICE中,并且都是使用同一时钟,时钟偏斜(skew,偏斜指时钟在因为途径寄存器不同或是负载不同,导致到达时间的空间变化)不会发生,而且可以支持超过350 MHz的时钟频率
- 简易FIFO








老师您好,在阅读本篇文章时,有几点疑问请老师解答:
1、文中有一句话“使用移位寄存器(SRL16E)分频的好处是不需要使用触发器,资源使用极少”,图9 SRL16E资源使用的表中也确实没有出现FF(触发器)的资源使用数据。可是移位寄存器(SRL16E)本身是由16个D触发器(也就是FF)组成的,对吗?是否可以理解为单纯使用SRL16E自身的FF资源就可以实现分频需求,同时SRL16E的FF资源如果不使用的话,也是一种浪费,这样理解对吗?
2、下方使用“时钟使能分频”实现8或者16分频的方式中,图10、图11中展示的FF资源使用情况,都少计算了一个clk_out 寄存器,仅仅统计的div_8的2bit(2个寄存器)、div_16的3bit(3个寄存器),是否应该加上clk_out寄存器呢?
1. 你的理解是正确的。
2. 之所以8分频只使用了2个触发器是因为代码综合后生成了一个latch + 2个触发器。latch使用了一个触发器的资源,只不过在综合的时候,没有报告出来,在布线中,可以看到,如下图所示:

同学学习课程非常仔细,给你点赞!